AI 도구 연동
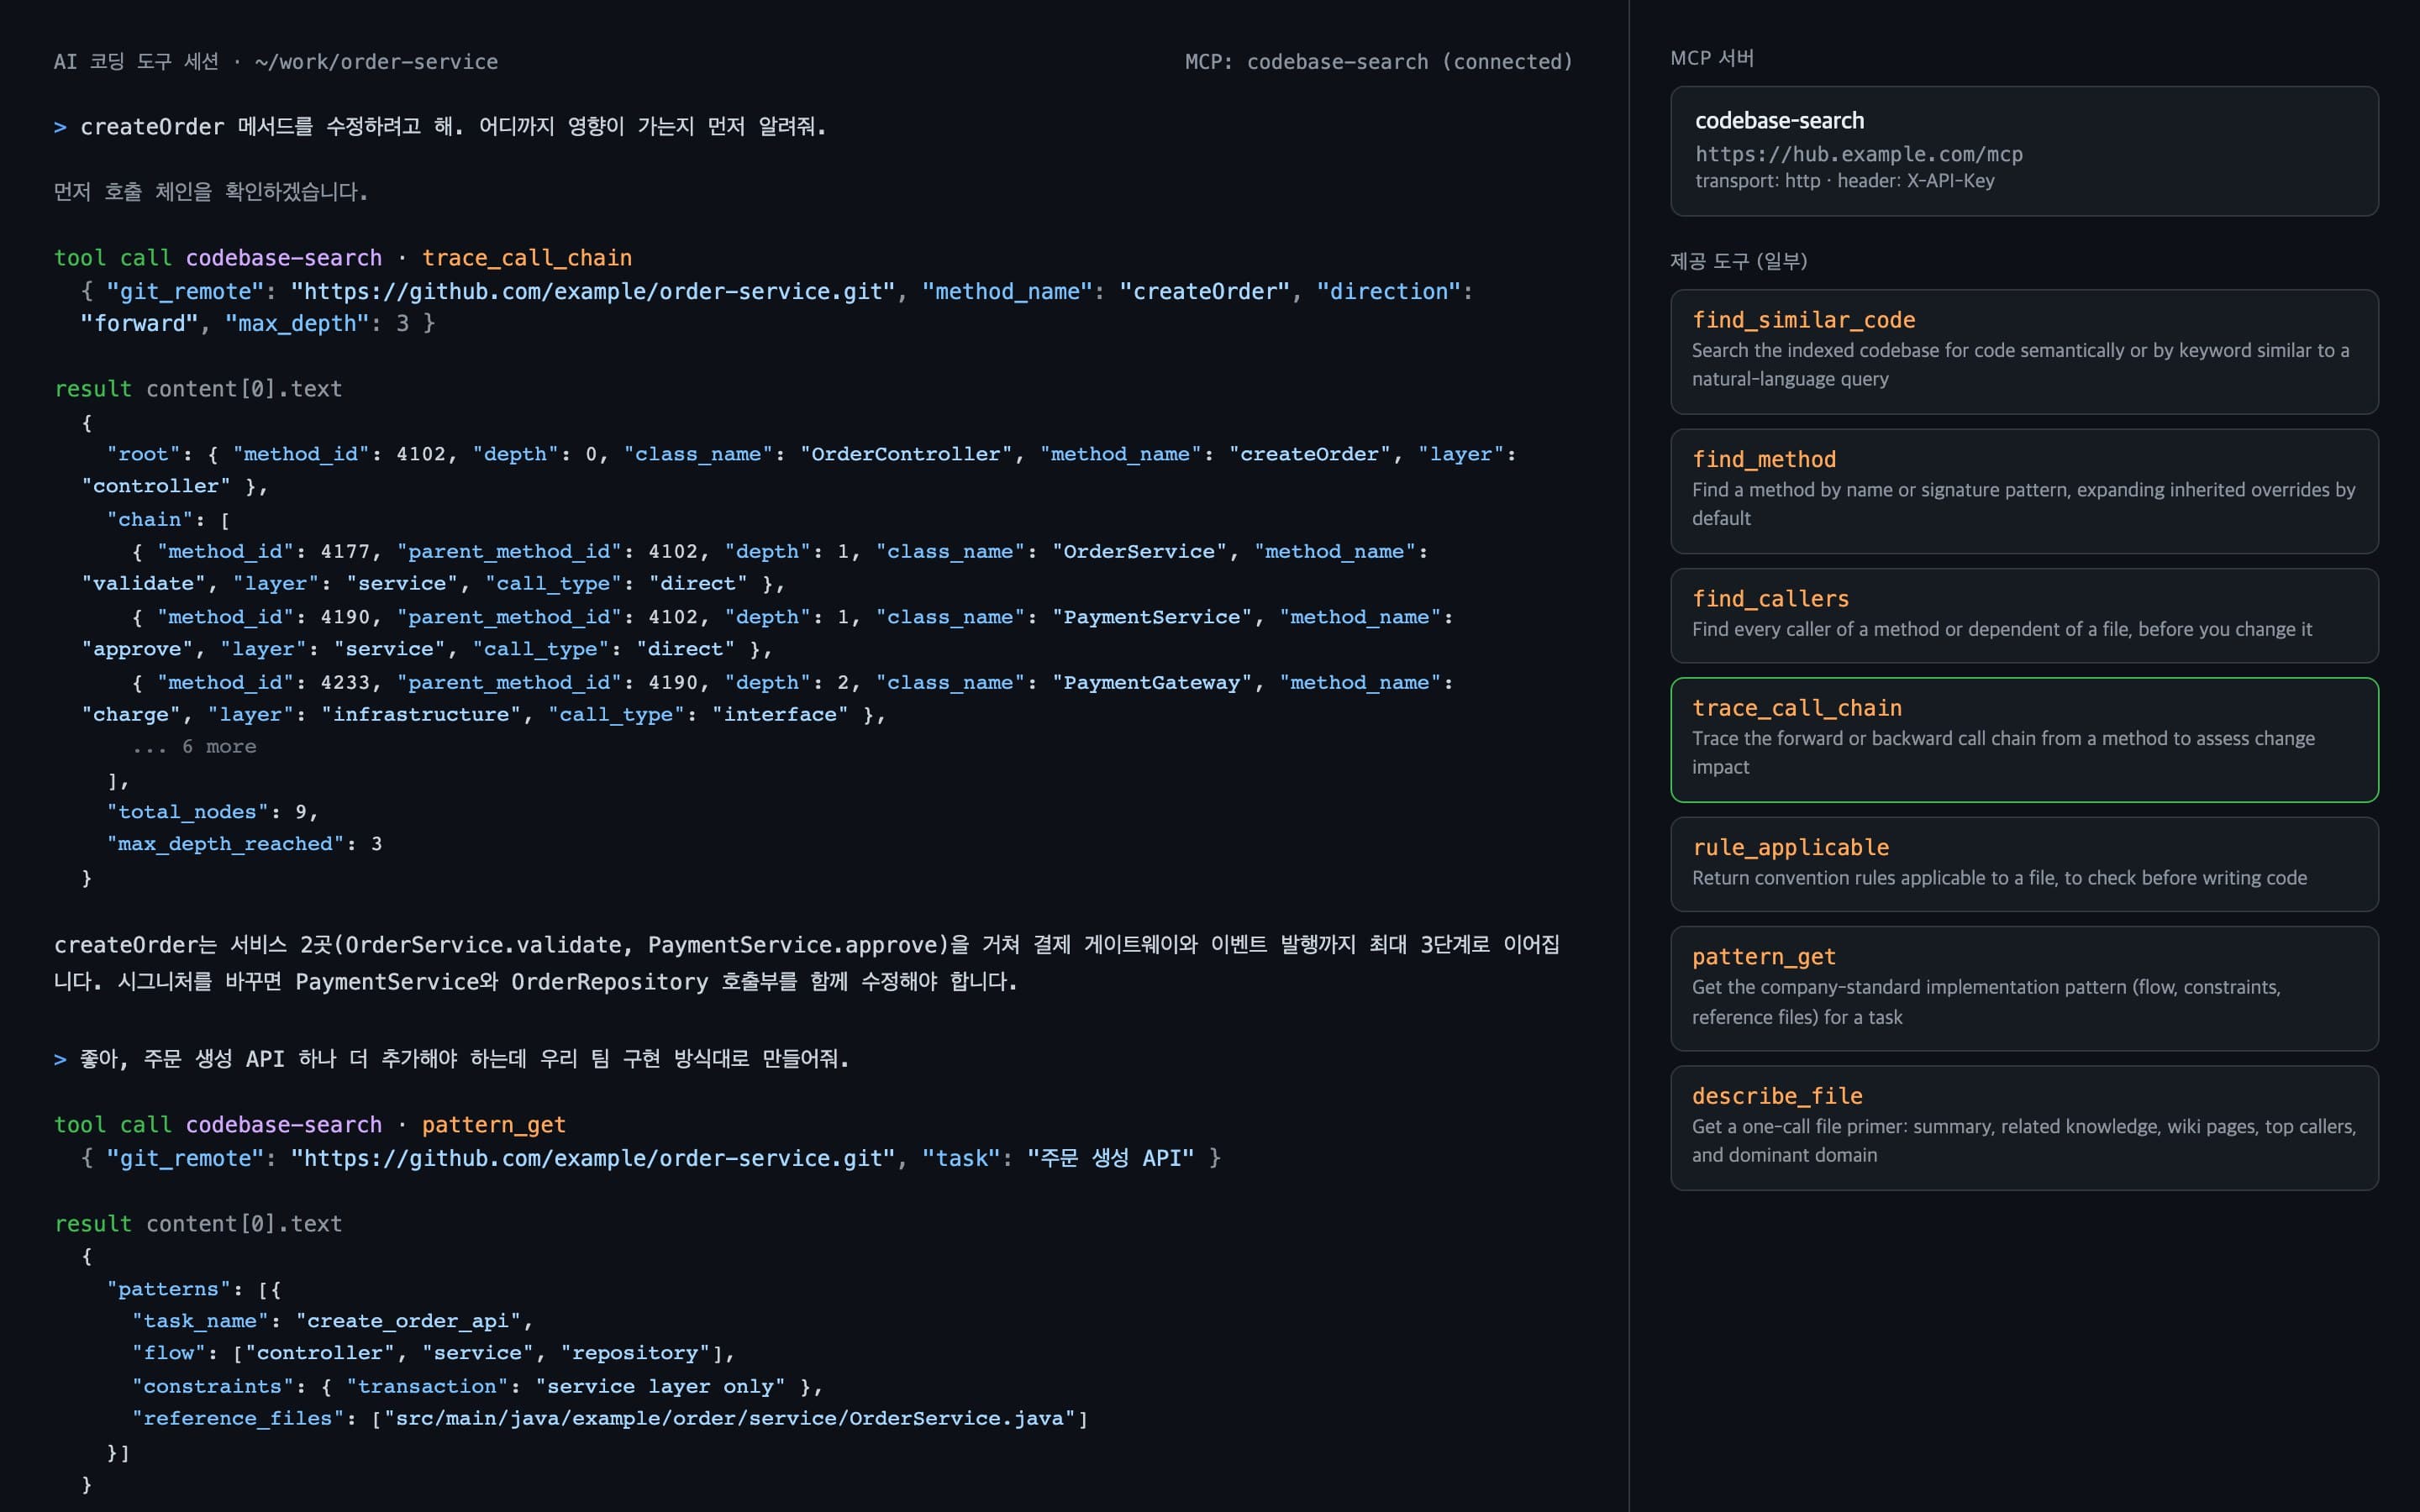
AI 코딩 도구가 작업을 시작하기 전에 코드 구조와 팀 규칙을 MCP 프로토콜로 직접 확인합니다. JSON-RPC 규격으로 호출 체인 추적, 유사 코드 검색, 아키텍처 규칙 검사를 호출해 필요한 맥락을 가져옵니다. 서버는 프로젝트 API 키를 검증한 뒤 색인된 지식과 구현 제약을 JSON 형식으로 돌려줍니다. 코딩 도구는 필요한 시점에만 맥락을 요청하므로 프롬프트 토큰을 아끼면서 코드를 고칩니다.
저장소를 분석해 코드 검색, 호출 관계, 팀 규칙, 결정 이력을 색인하고 AI 코딩 도구에 MCP로 전달하는 코드 컨텍스트 서버입니다.
Features
AI 코딩 도구가 작업을 시작하기 전에 코드 구조와 팀 규칙을 MCP 프로토콜로 직접 확인합니다. JSON-RPC 규격으로 호출 체인 추적, 유사 코드 검색, 아키텍처 규칙 검사를 호출해 필요한 맥락을 가져옵니다. 서버는 프로젝트 API 키를 검증한 뒤 색인된 지식과 구현 제약을 JSON 형식으로 돌려줍니다. 코딩 도구는 필요한 시점에만 맥락을 요청하므로 프롬프트 토큰을 아끼면서 코드를 고칩니다.
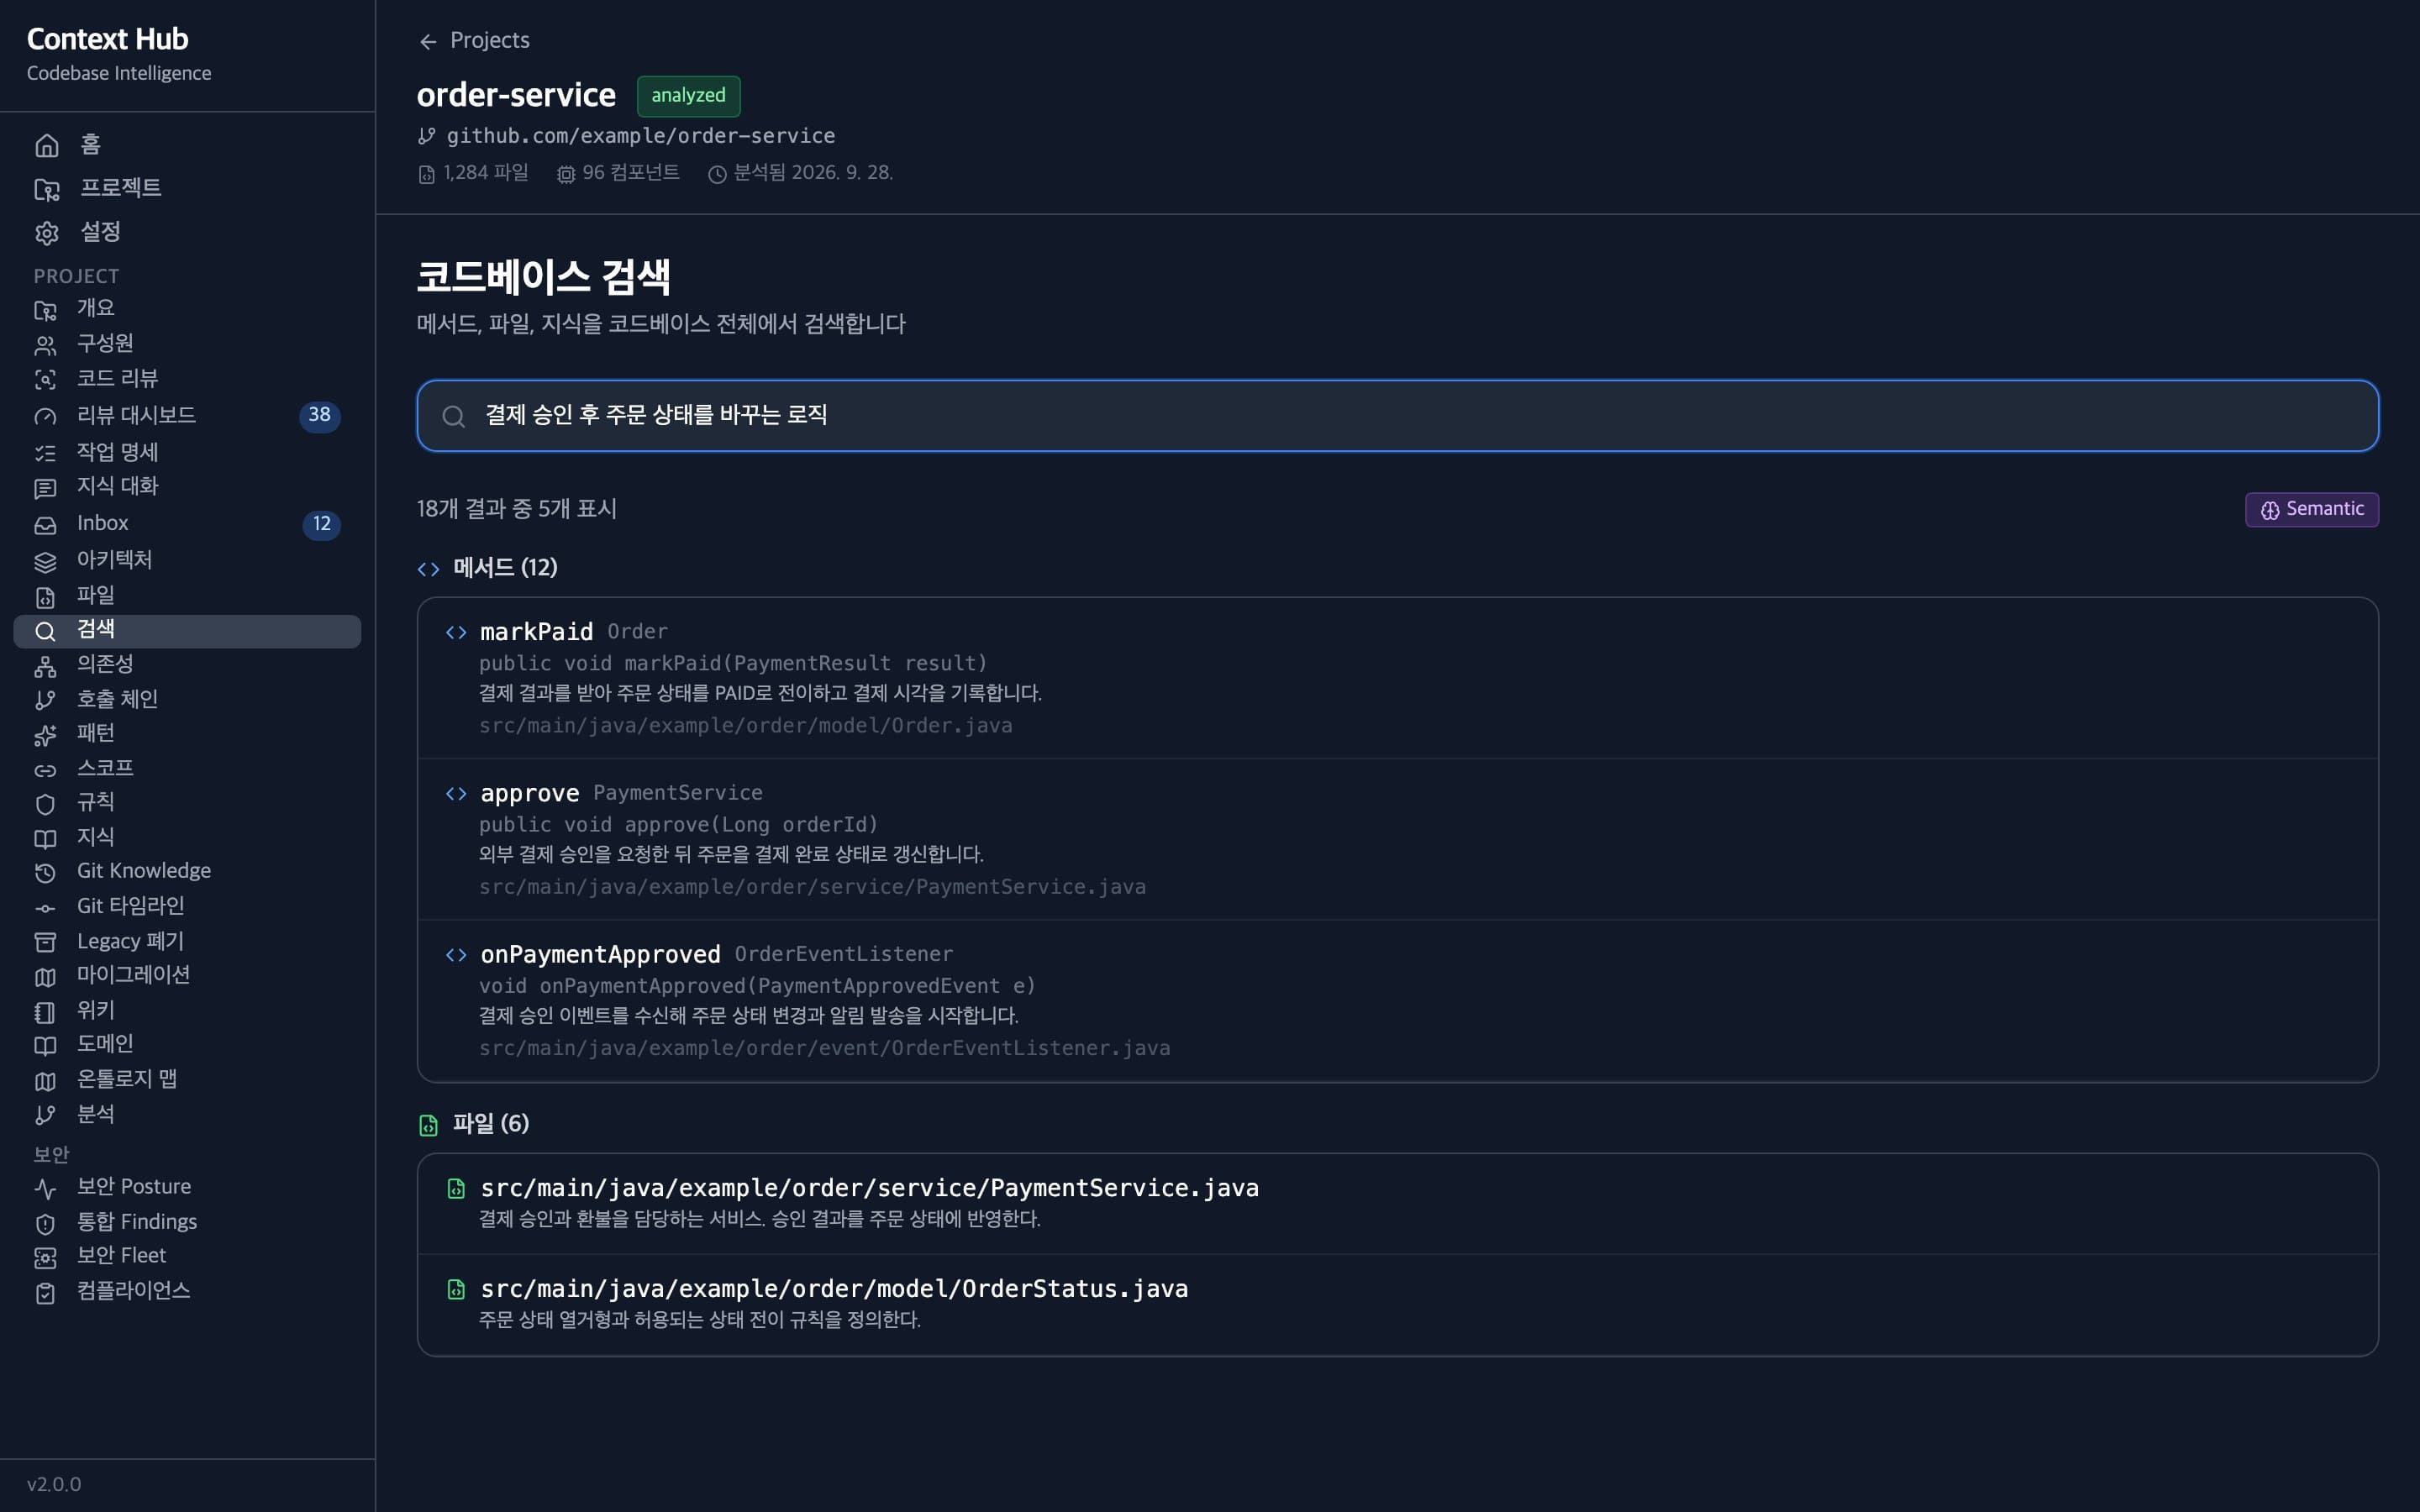
자연어 설명이나 파일 경로, 함수 이름을 넣으면 관련 메서드와 파일을 찾습니다. 캐시 확인, 키워드 일치, 벡터 의미 검색을 차례로 거치고 순위를 합쳐 결과를 냅니다. 결과 목록에는 적중 방식과 함께 메서드 서명, 파일 경로, 역할 요약이 붙습니다. 정확한 이름을 모르는 상태에서도 동작 설명으로 원하는 코드를 찾습니다.
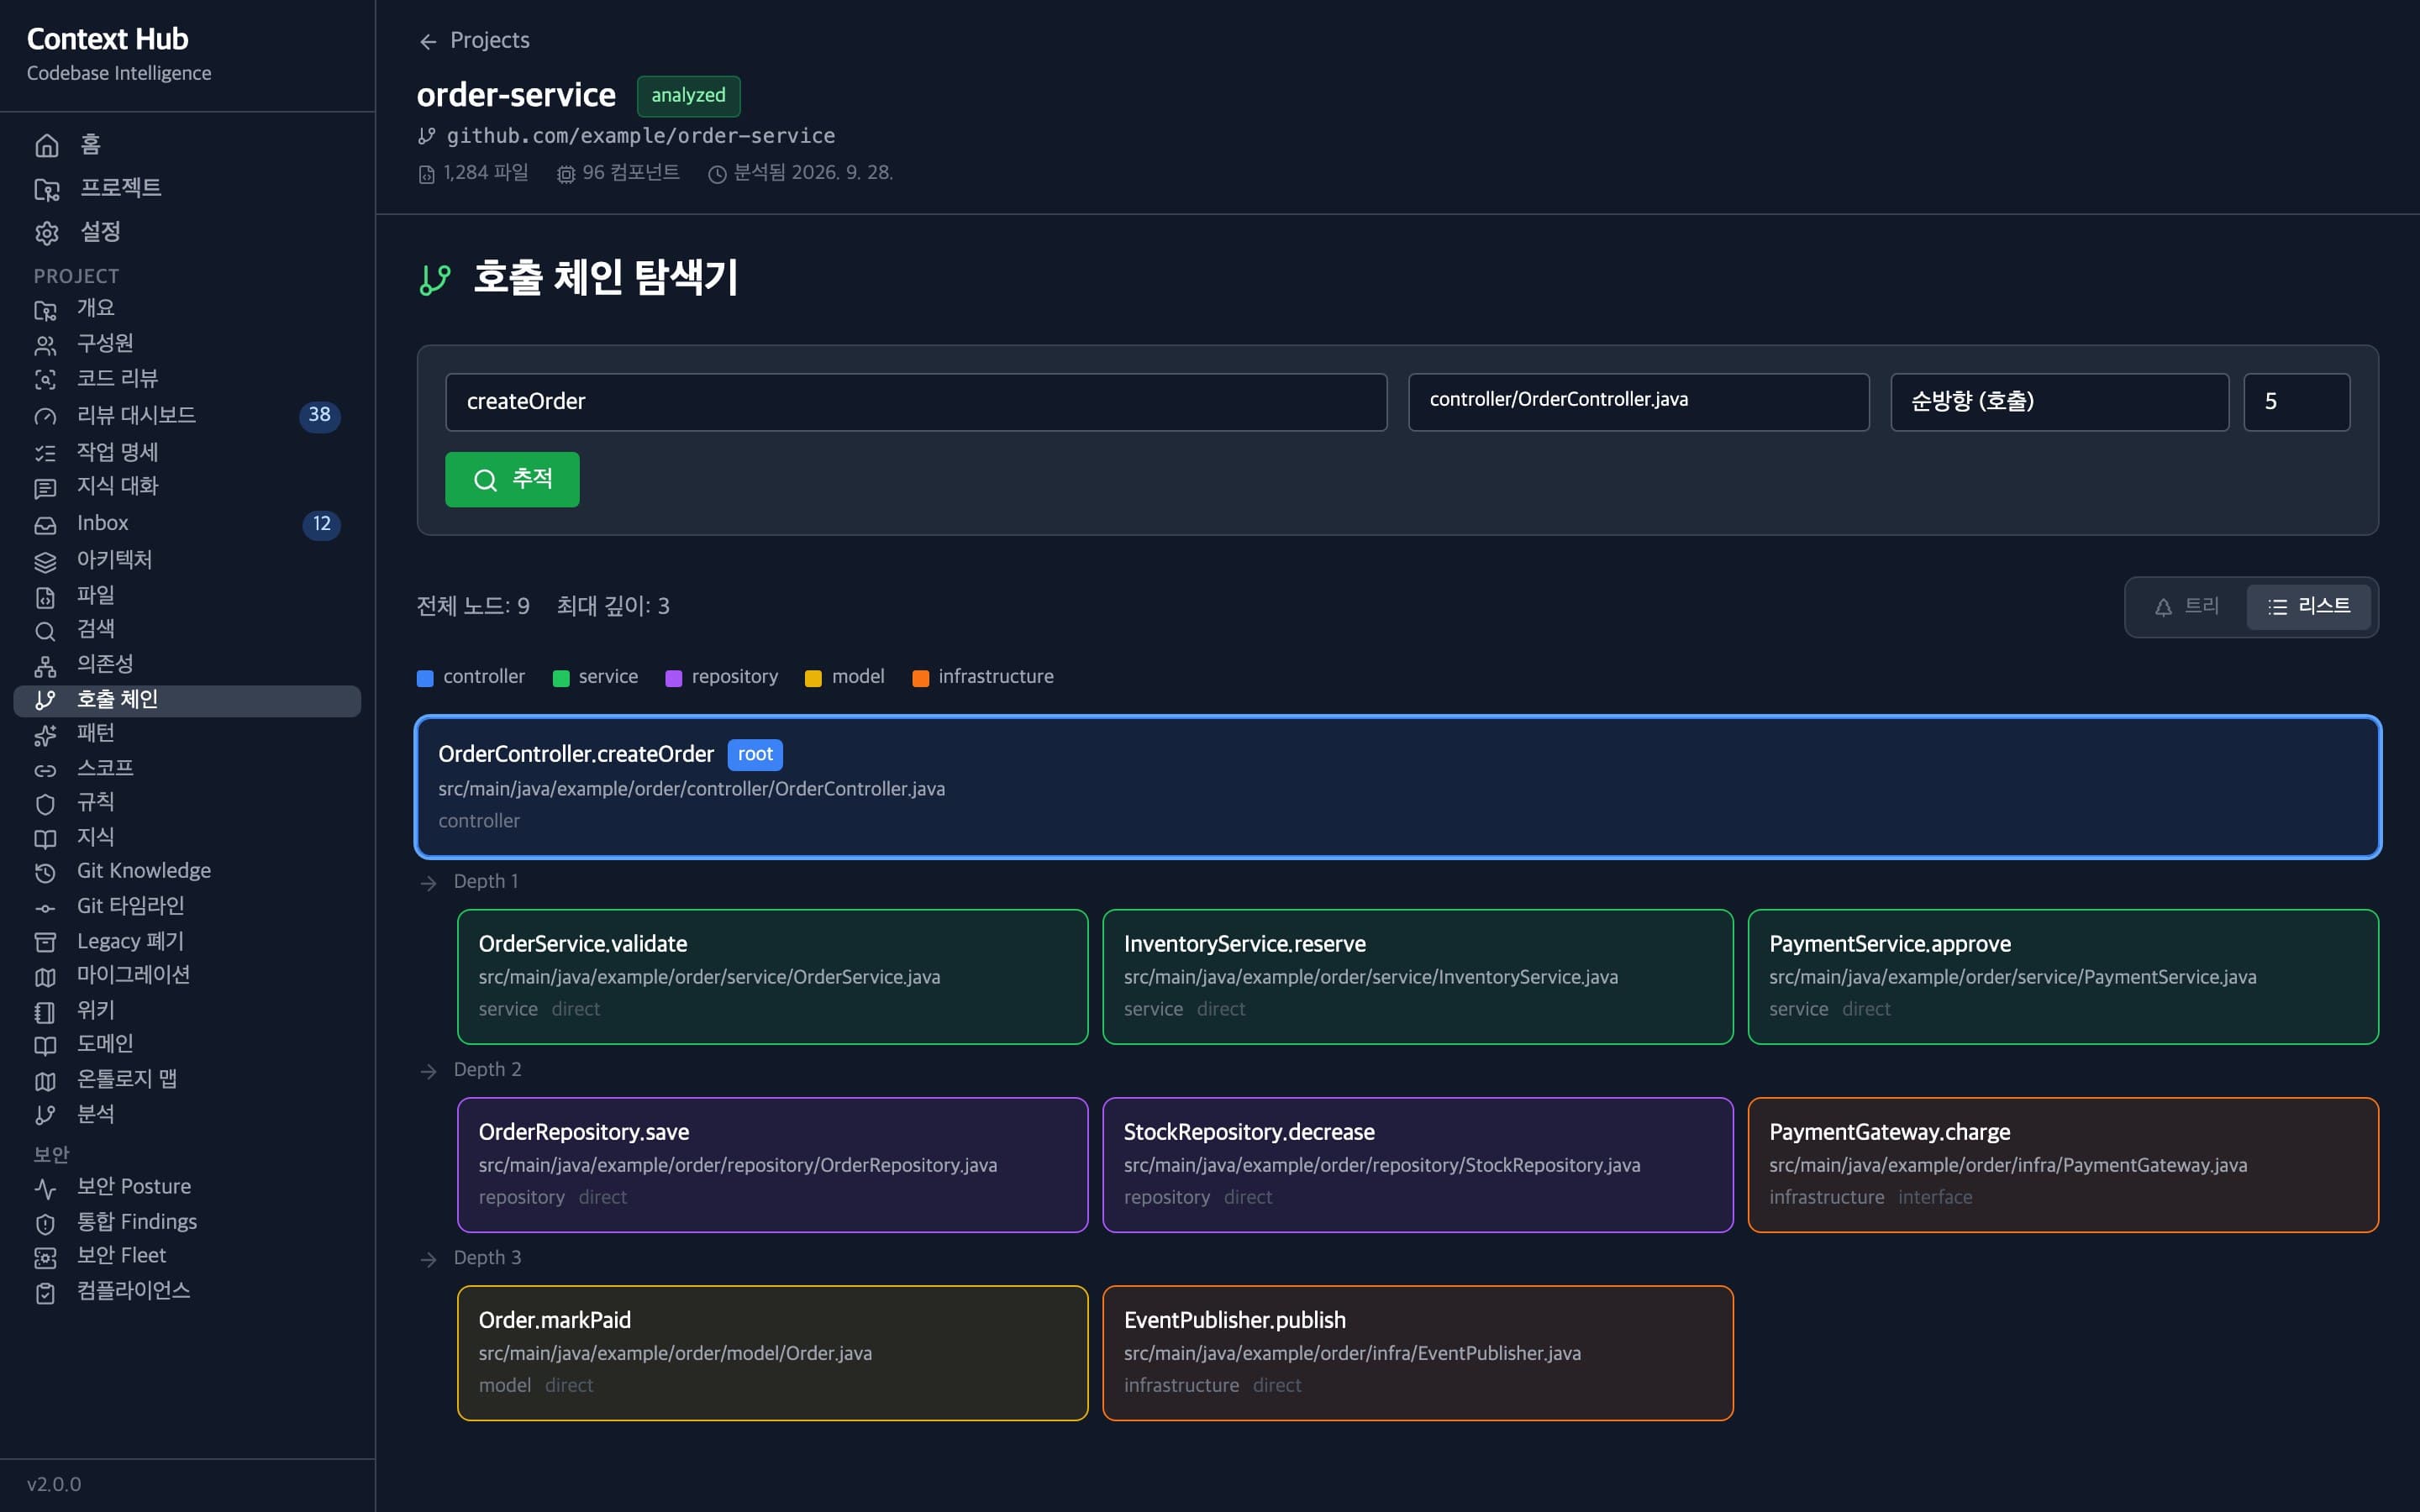
기준 메서드가 호출하는 코드나 그 메서드를 부르는 상위 코드를 최대 10단계까지 따라갑니다. 각 노드는 컨트롤러, 서비스, 저장소, 모델, 인프라 계층으로 나뉘며 직접 호출과 인터페이스 경유 호출을 구분합니다. 전체 호출 경로에서 확인된 노드 수와 도달 깊이를 합산해 변경 영향 범위를 계산합니다. 공통 함수를 손대기 전에 어느 곳이 영향을 받는지 미리 확인하거나 순환 호출을 점검할 때 씁니다.
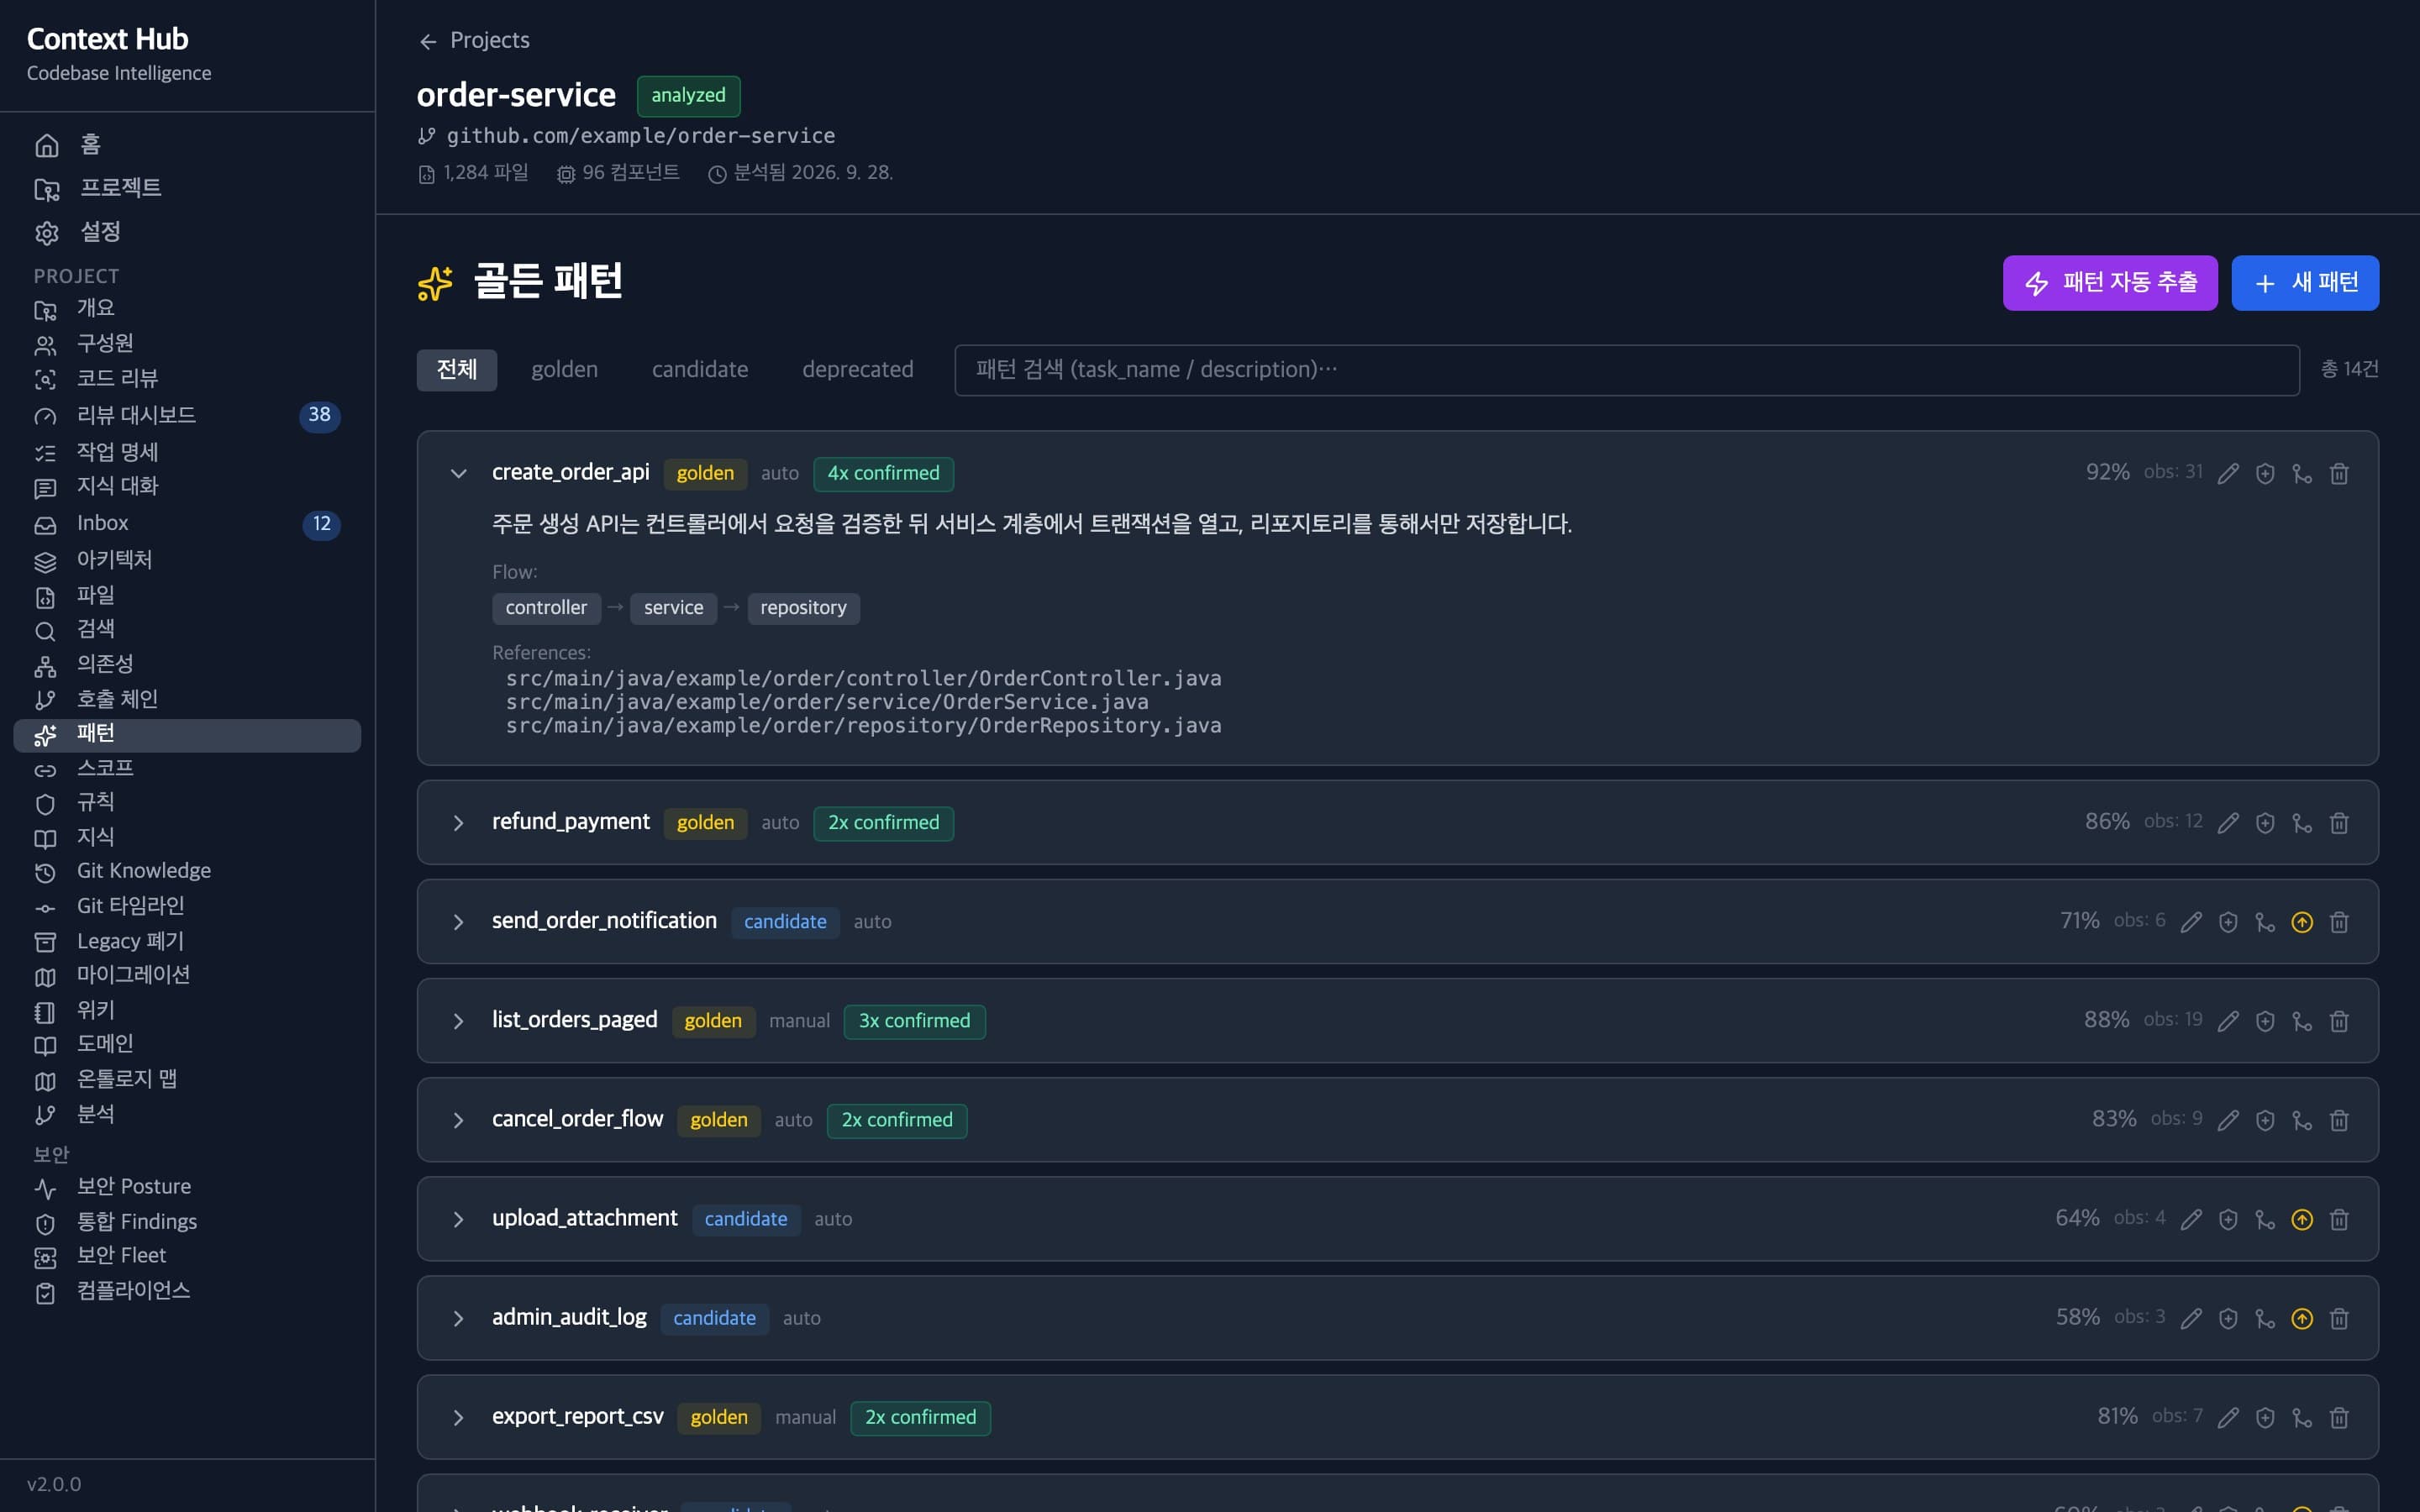
저장소 안에서 자주 나타나는 구현 방식을 추출해 팀 표준 패턴으로 등록합니다. 패턴 상태는 후보, 골든, 폐기로 나뉘며 여러 곳에서 쓰인 구현은 골든 패턴으로 올립니다. 패턴에는 계층별 호출 순서와 제약 조건, 참고 파일 목록이 들어가고 작성 코드가 이 기준에 맞는지 점수를 매깁니다. 비슷한 기능을 새로 만들 때 팀의 기존 구현 방식을 그대로 따르도록 기준을 제시합니다.
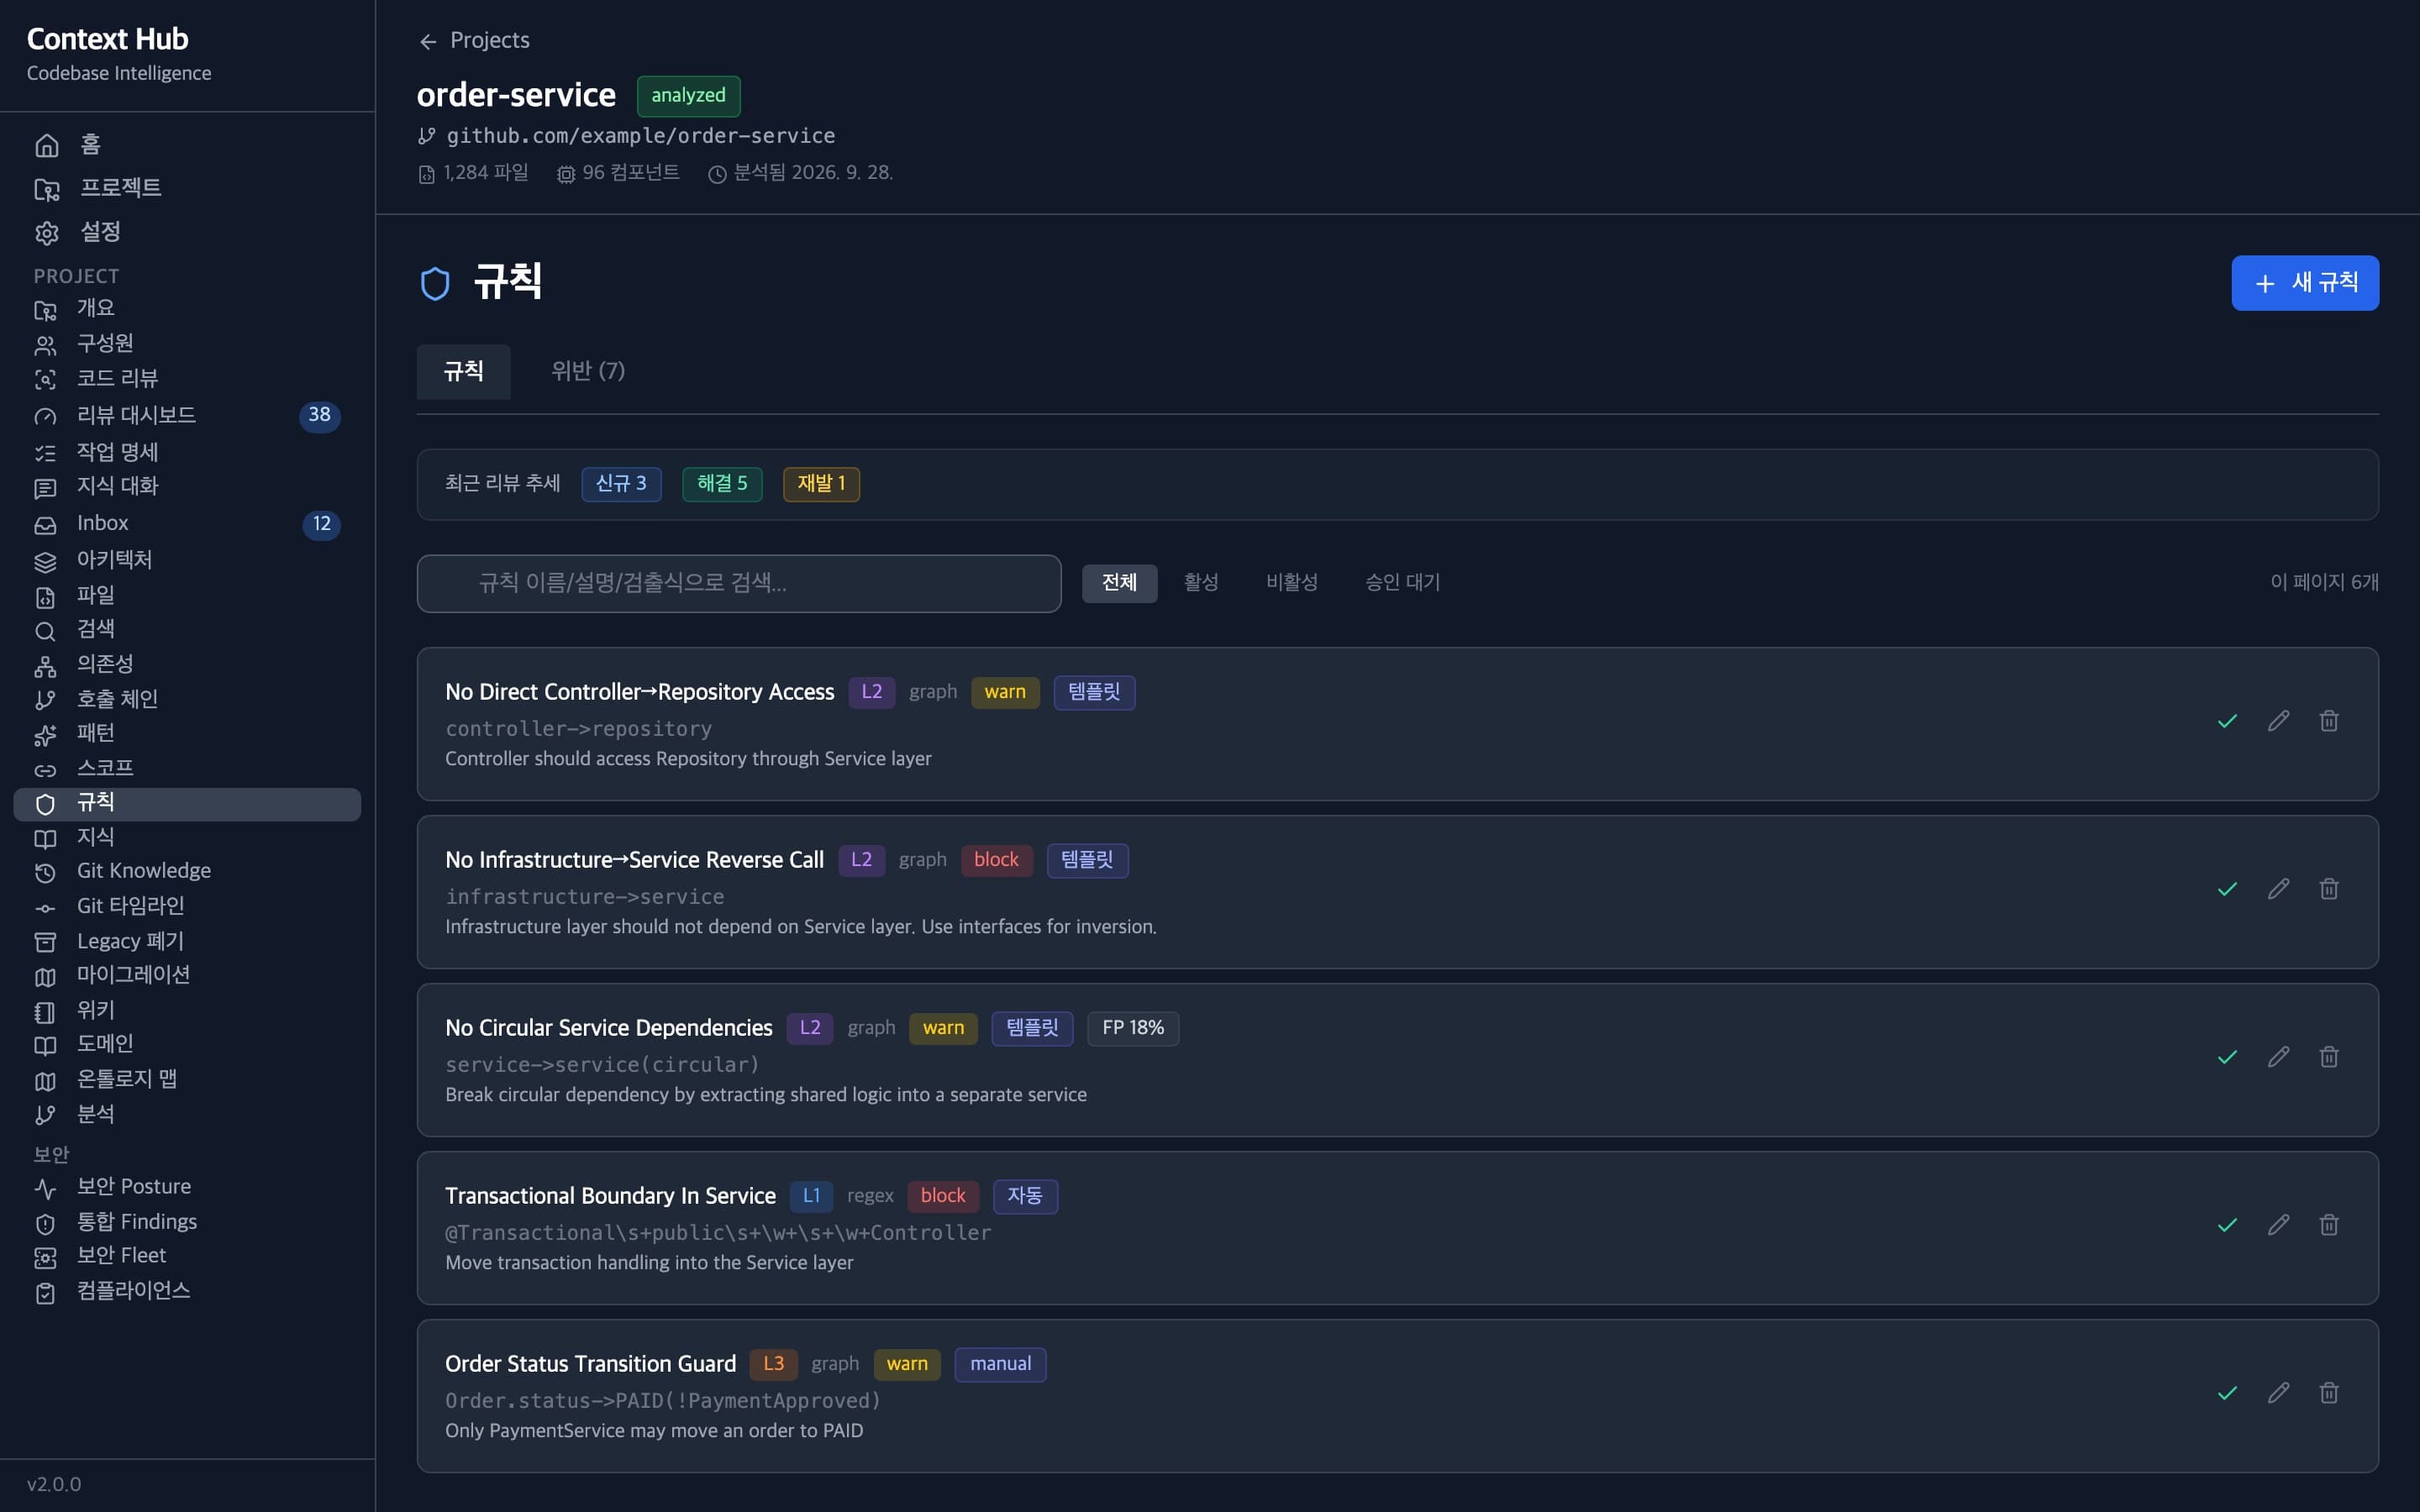
계층 간 역참조나 금지된 모듈 호출 같은 아키텍처 규칙을 등록해 코드 위반을 잡습니다. 규칙은 L1부터 L3까지의 등급과 정규식 또는 그래프 검사 방식을 쓰며, 위반 시 조치는 경고와 차단으로 나뉩니다. 새로 만든 규칙은 승인 대기 상태를 거쳐 켜지고 위반 시 어떻게 고쳐야 하는지 안내 문구가 함께 들어갑니다. 코드 검토에서 오탐 비율이 30%를 넘는 규칙은 자동으로 등급을 낮춰 불필요한 알림을 줄입니다.
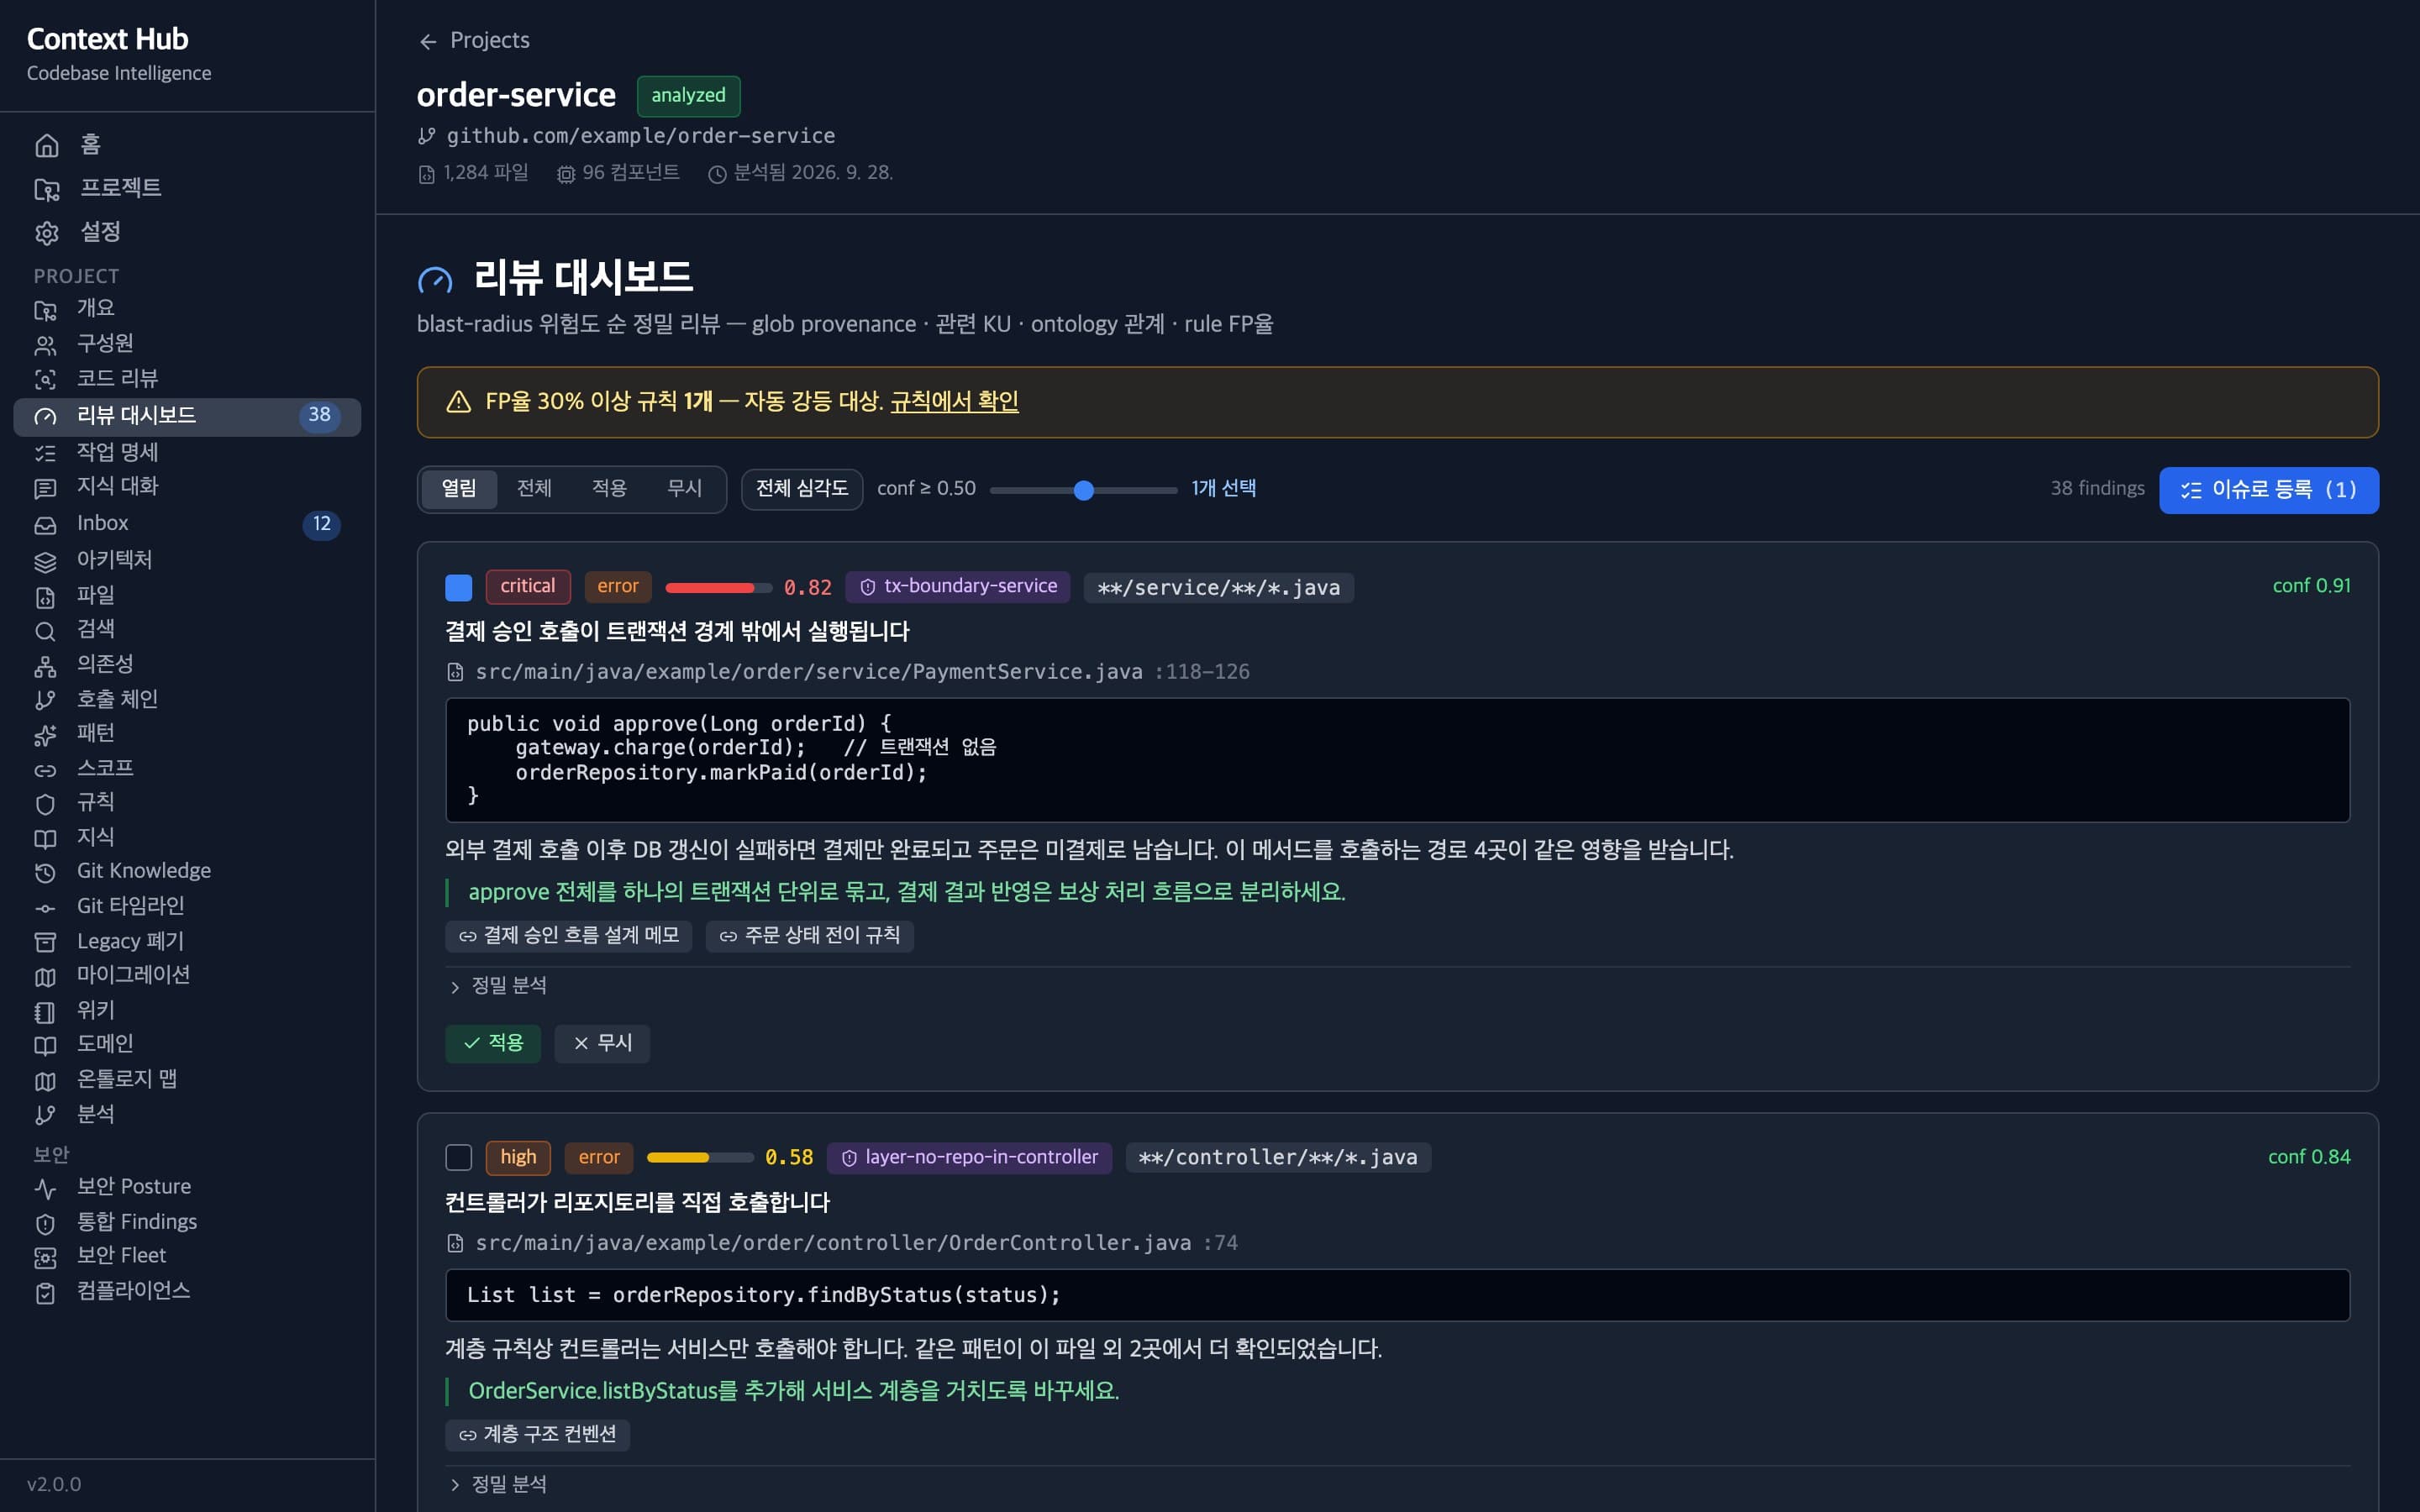
코드 변경 내용과 풀 리퀘스트를 읽어 컨벤션 위반과 수정 범위를 검토합니다. 지적 사항은 위험 순서로 나열되며 심각도, 규칙 이름, 파일 줄 번호, 수정 diff가 함께 붙습니다. 검토자는 각 지적의 이유와 관련 문서를 확인한 뒤 적용하거나 무시로 넘깁니다. 잘못 지적하는 일이 잦은 규칙은 강등 검토 대상으로 분류해 따로 모읍니다.
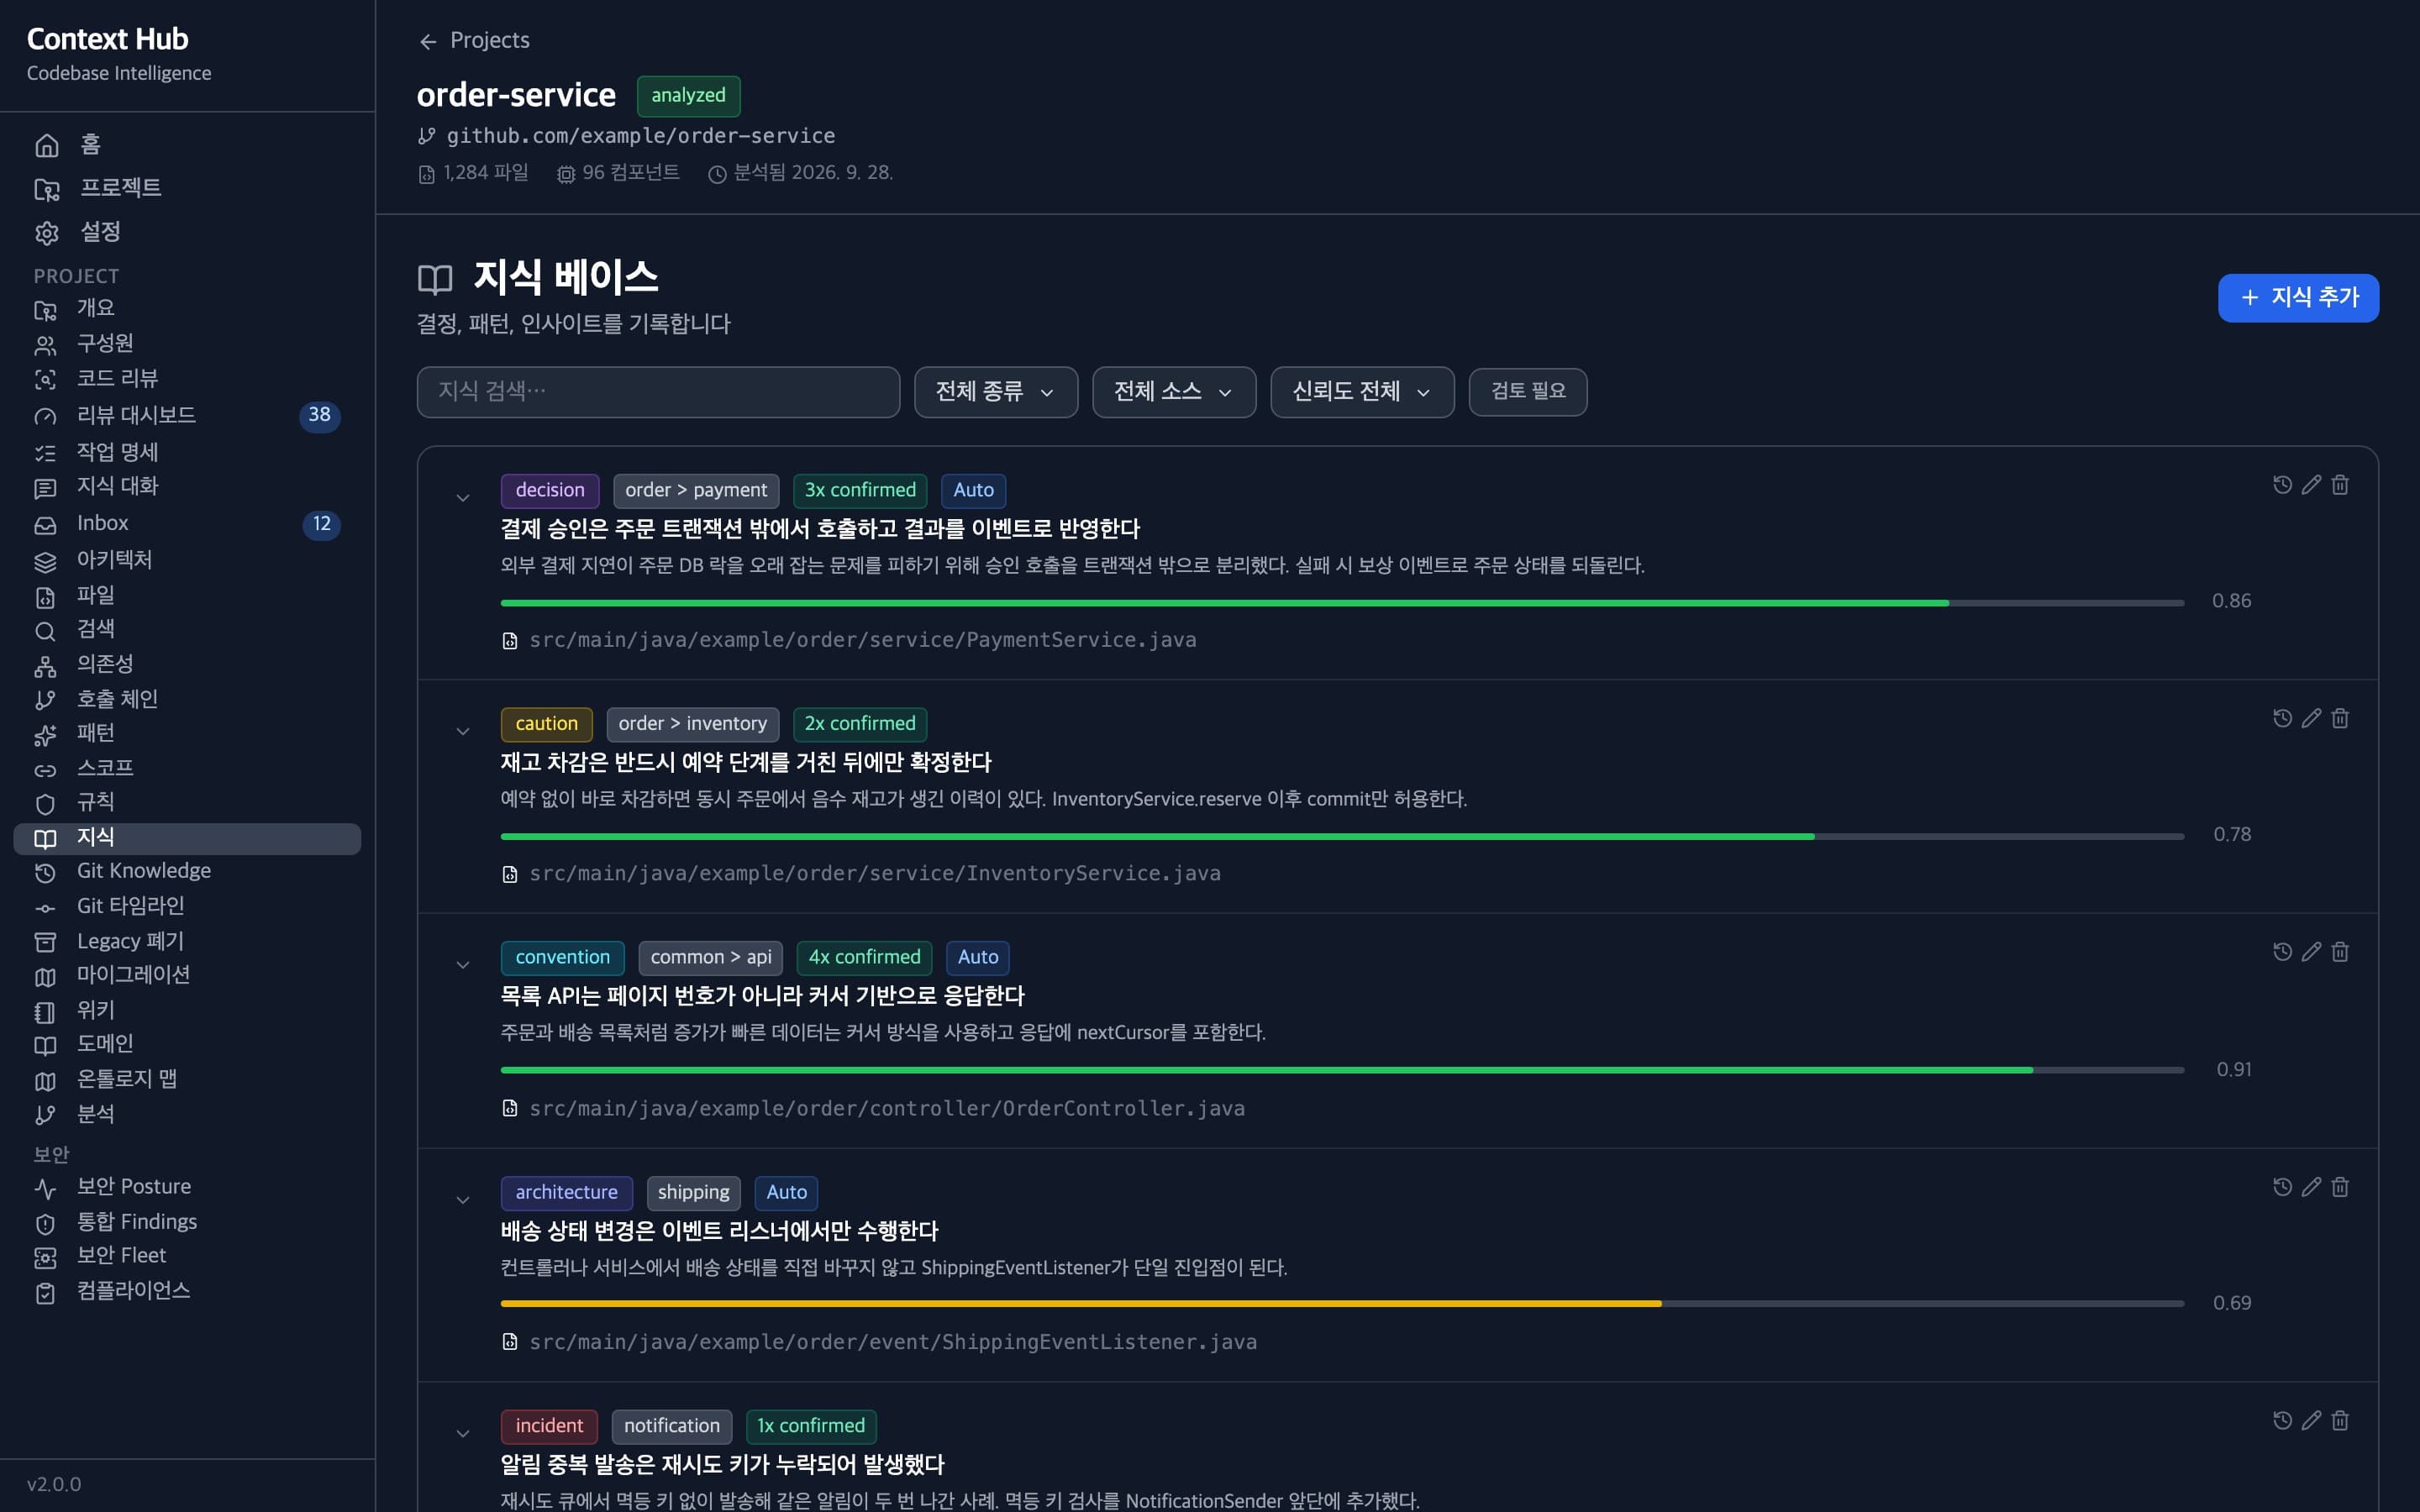
개발하면서 내린 결정, 설계 규칙, 주의 사항을 근거 파일과 함께 모아 둡니다. 지식 항목은 결정, 주의사항, 규칙, 아키텍처, 장애로 분류하고 정한 이유와 신뢰도 점수를 적어 둡니다. 저장할 때 주민번호나 전화번호 같은 개인정보는 자동으로 가려집니다. AI 코딩 도구나 새로 합류한 개발자가 이 지식을 찾아보고 같은 실수를 되풀이하지 않게 막습니다.
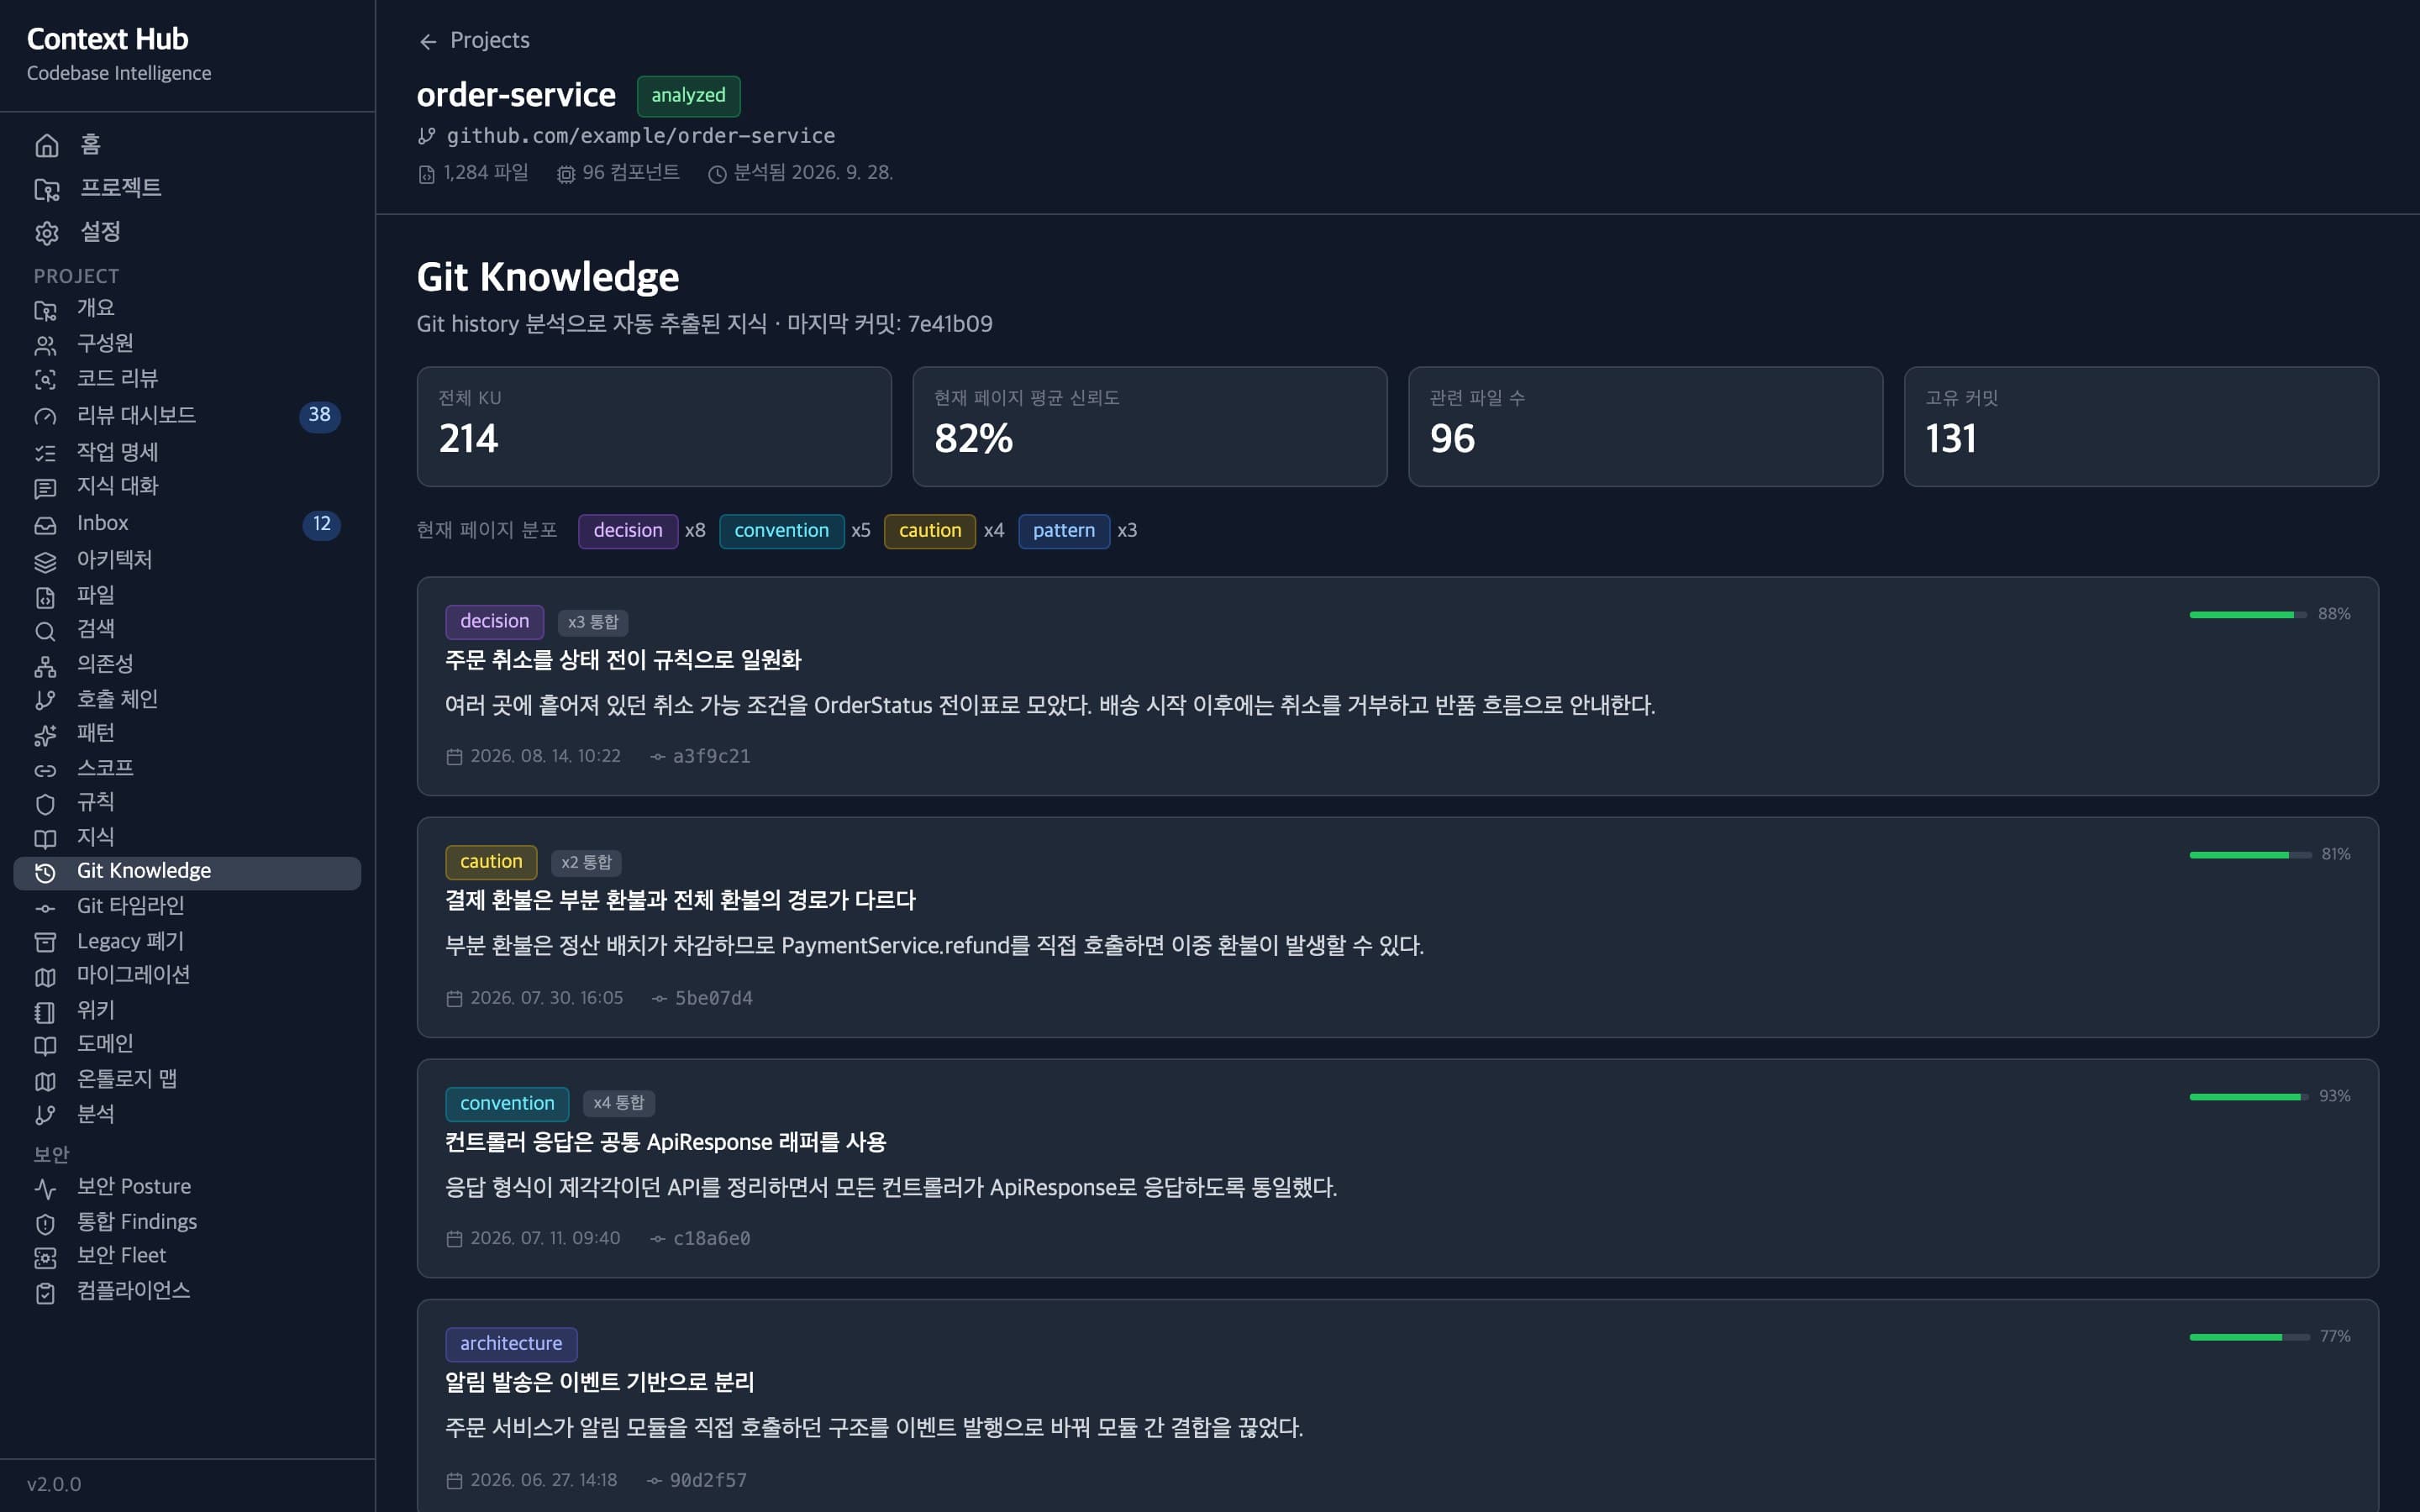
Git 커밋 로그와 변경 내용을 분석해 코드에 적히지 않은 설계 의도와 결정 사항을 추출합니다. 추출한 내용은 결정, 규칙, 주의사항, 패턴으로 나누고 커밋 해시와 작성 시각을 연결해 둡니다. 여러 커밋에서 같은 내용이 반복되면 하나로 합치고 몇 번 나타났는지 횟수를 남깁니다. 과거 코드가 왜 이렇게 바뀌었는지 이유를 확인하고 수정 방향을 정할 때 씁니다.
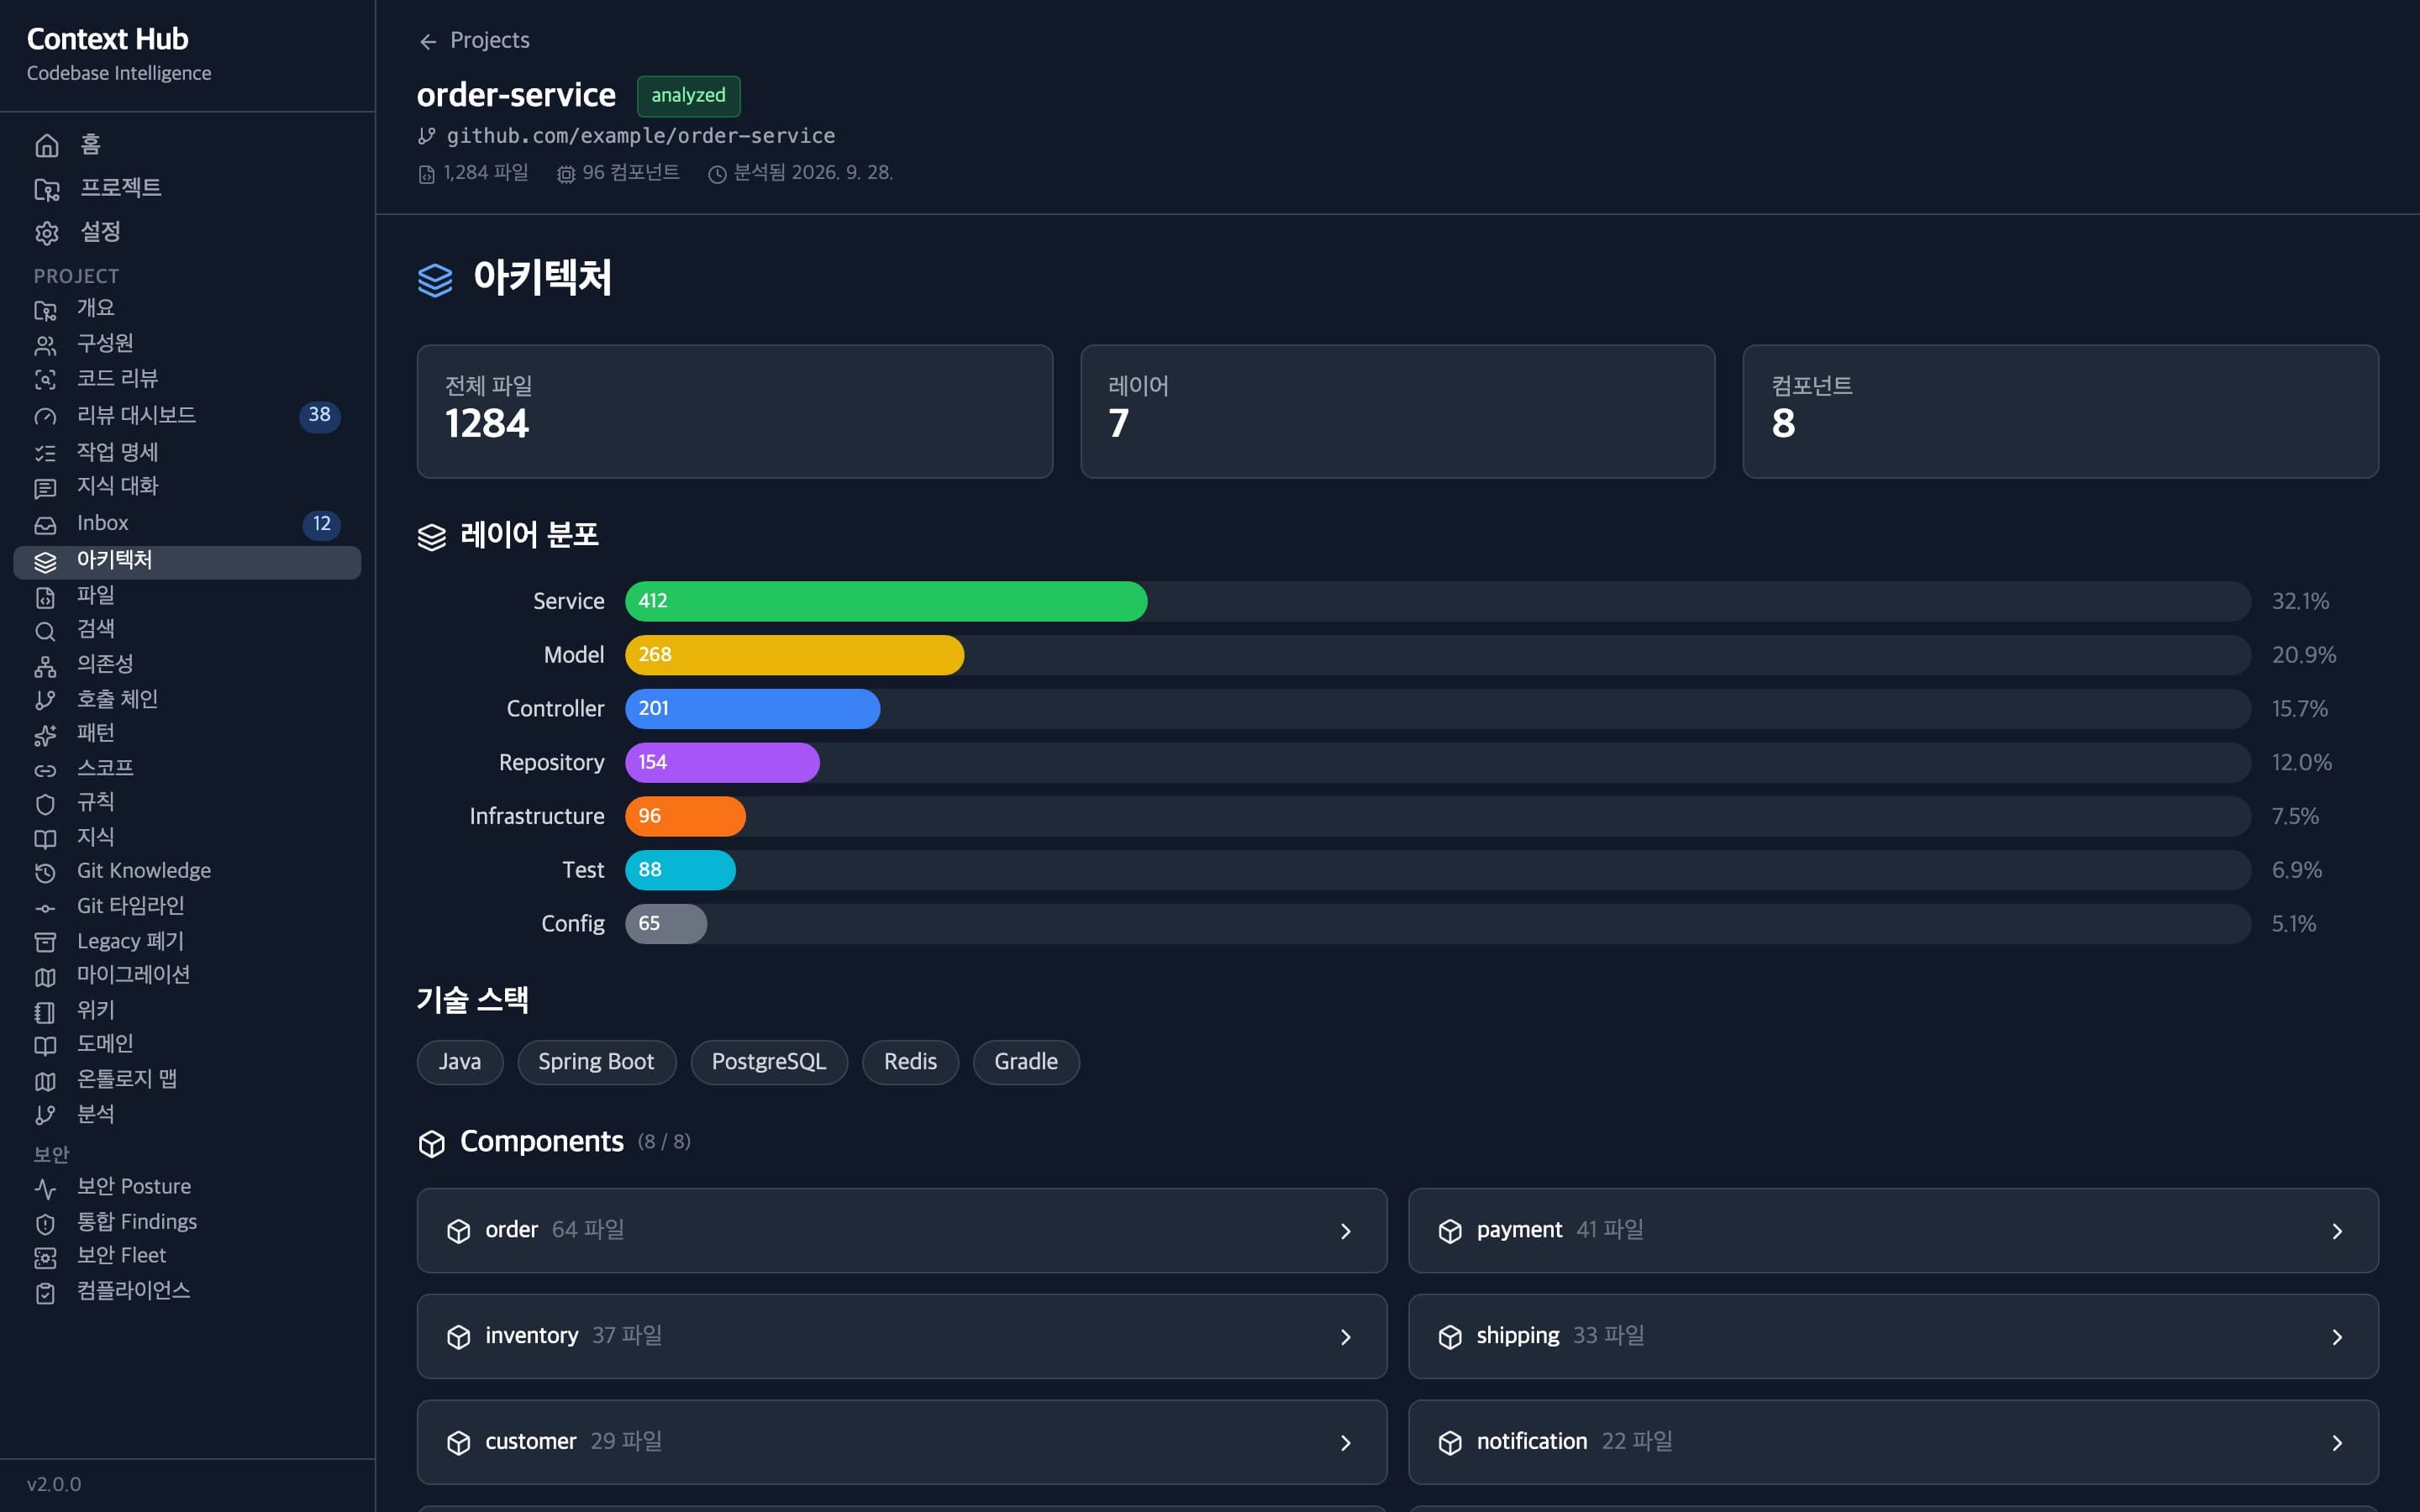
저장소 안의 모든 소스 파일을 컨트롤러, 서비스, 저장소, 모델, 인프라, 설정, 테스트로 자동 분류합니다. 계층마다 파일 수와 비중을 계산하고 도메인 컴포넌트와 기술 스택 목록을 정리해 둡니다. 시스템 시작 지점과 코드를 읽는 권장 순서를 계산해 처음 코드를 보는 개발자의 길잡이로 삼습니다. 이 구조 정보는 웹 화면뿐 아니라 MCP 도구로도 AI 코딩 도구에 그대로 전달됩니다.
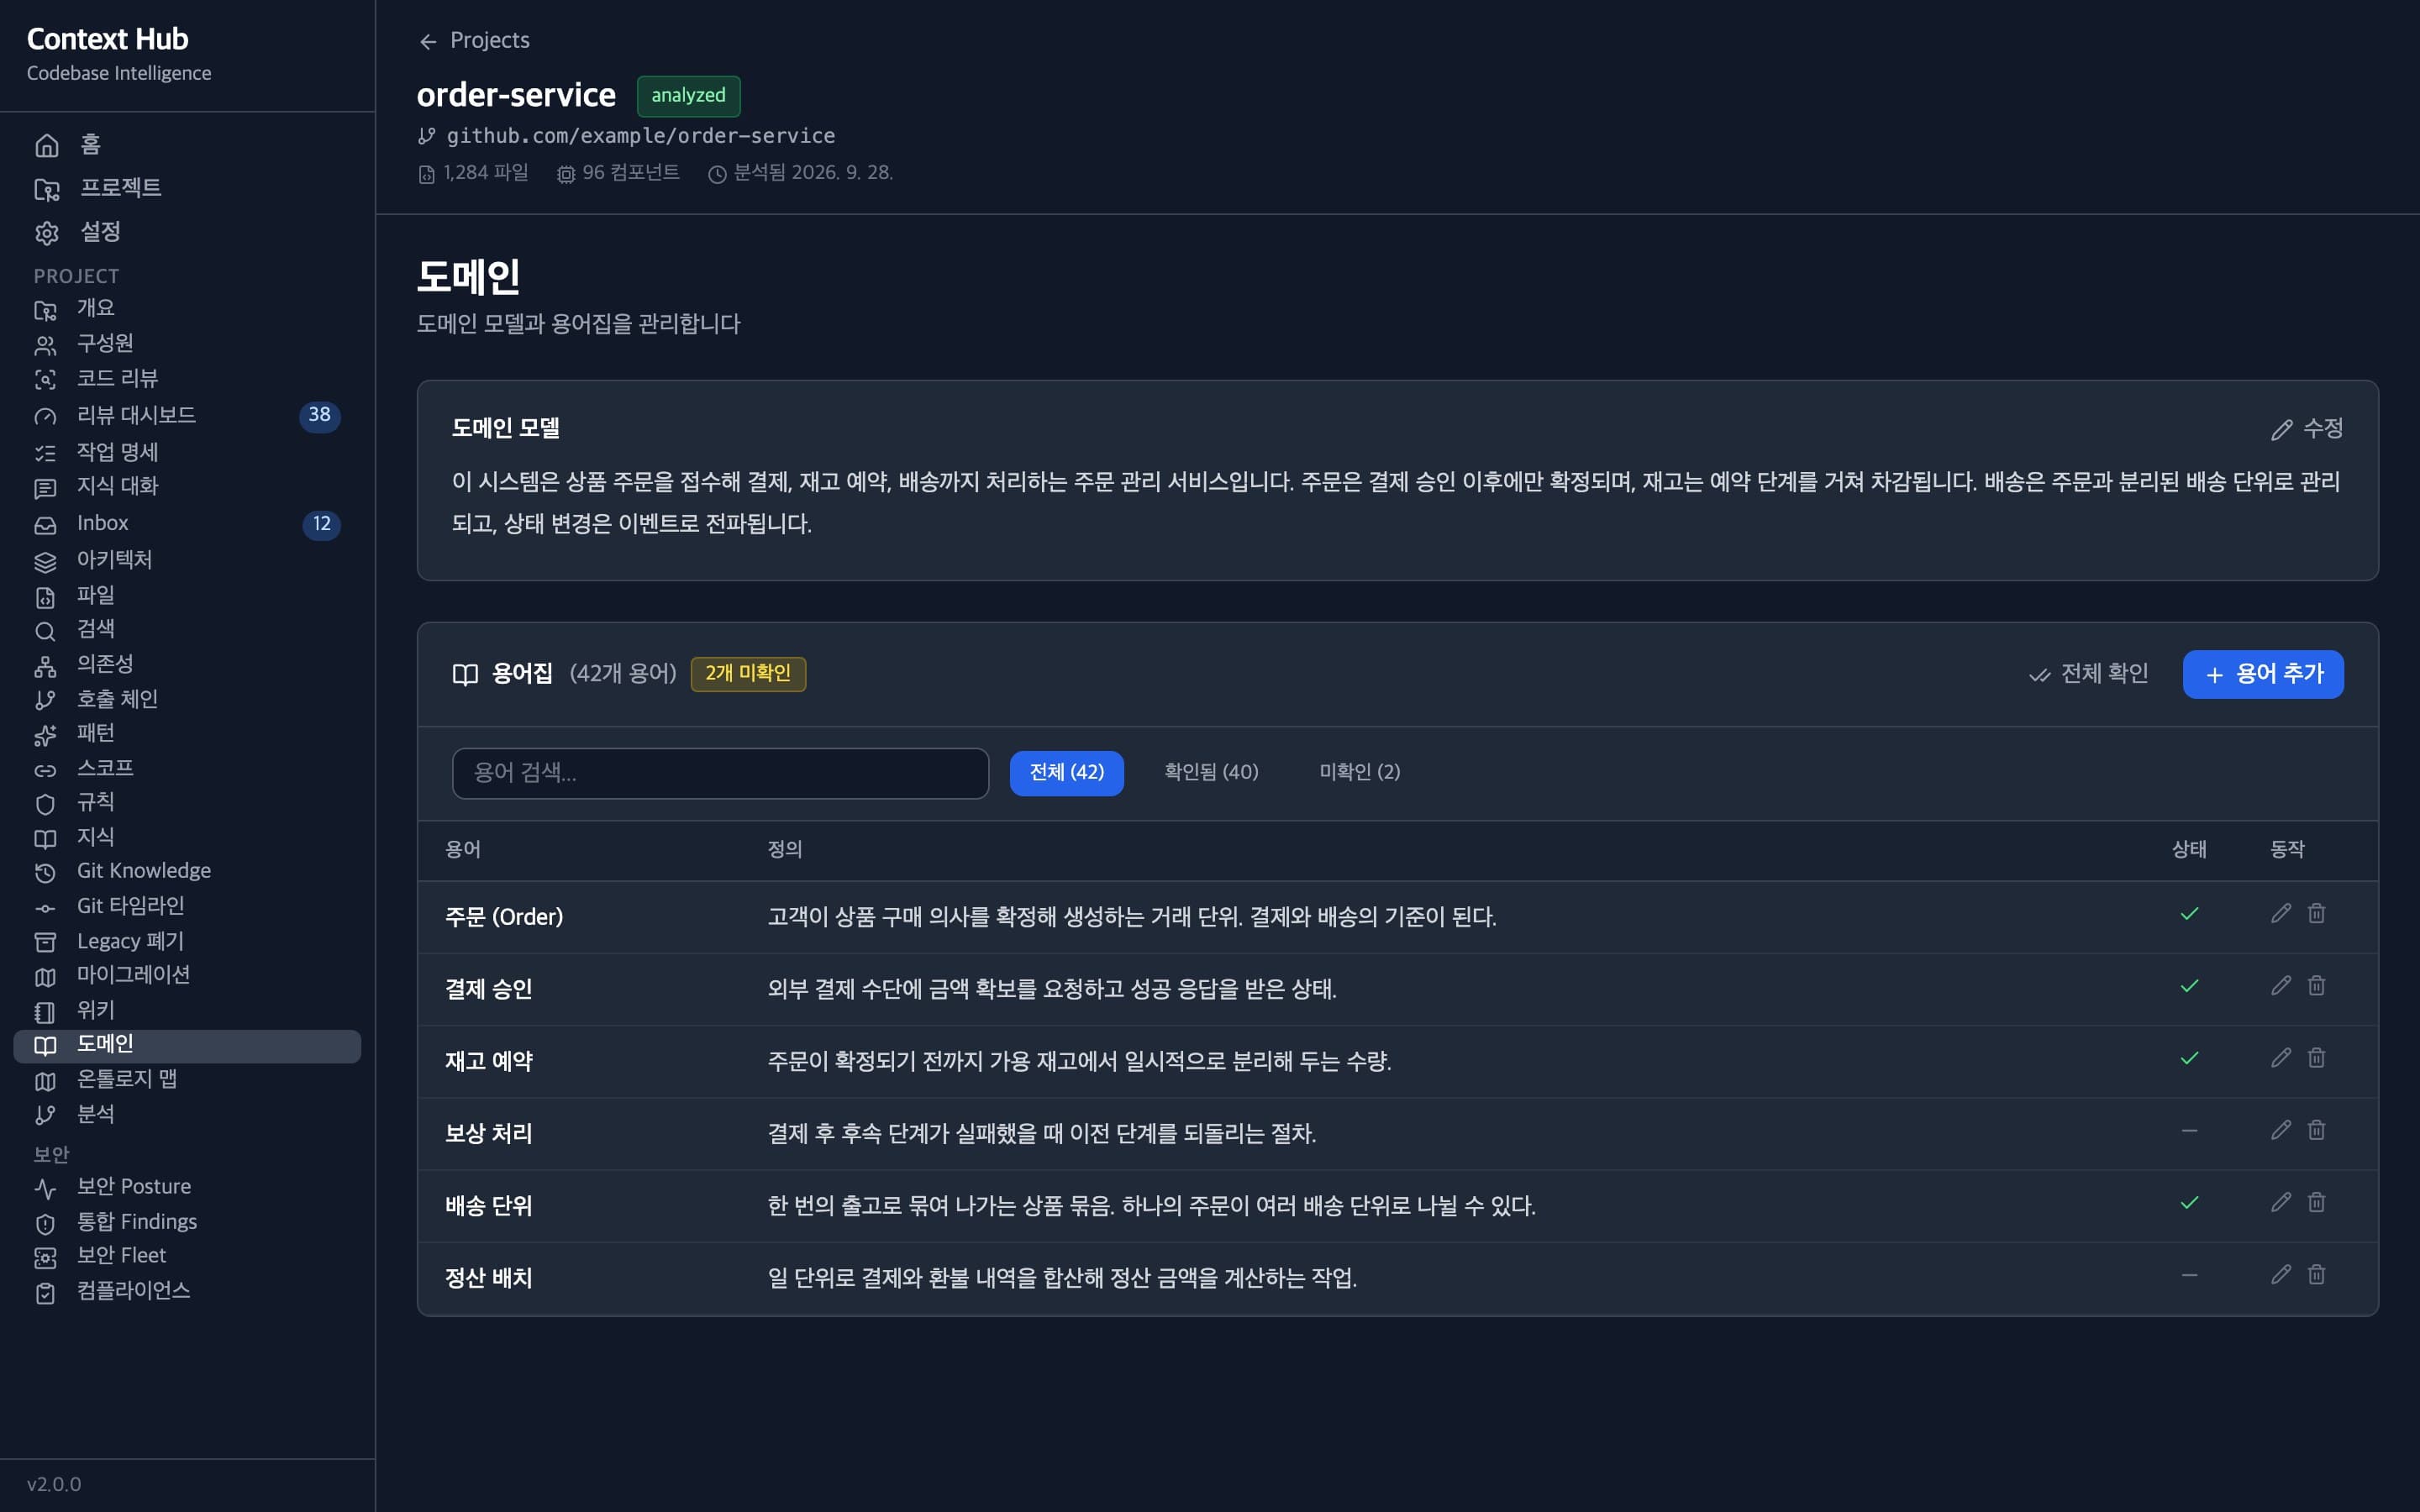
시스템이 다루는 업무 규칙 설명과 소스 코드에서 추출한 용어 사전을 함께 관리합니다. 업무 설명 초안은 자동 분석으로 만들고 사람이 직접 고칠 수 있으며, 용어는 확인됨과 미확인 상태로 나뉩니다. 코드에서 새로 찾은 용어는 검토를 거쳐 확인 처리하며 빠진 단어는 직접 적어 넣습니다. 개발팀과 AI 도구가 업무 용어를 코드 이름과 같은 뜻으로 이해하고 쓰게 맞춥니다.
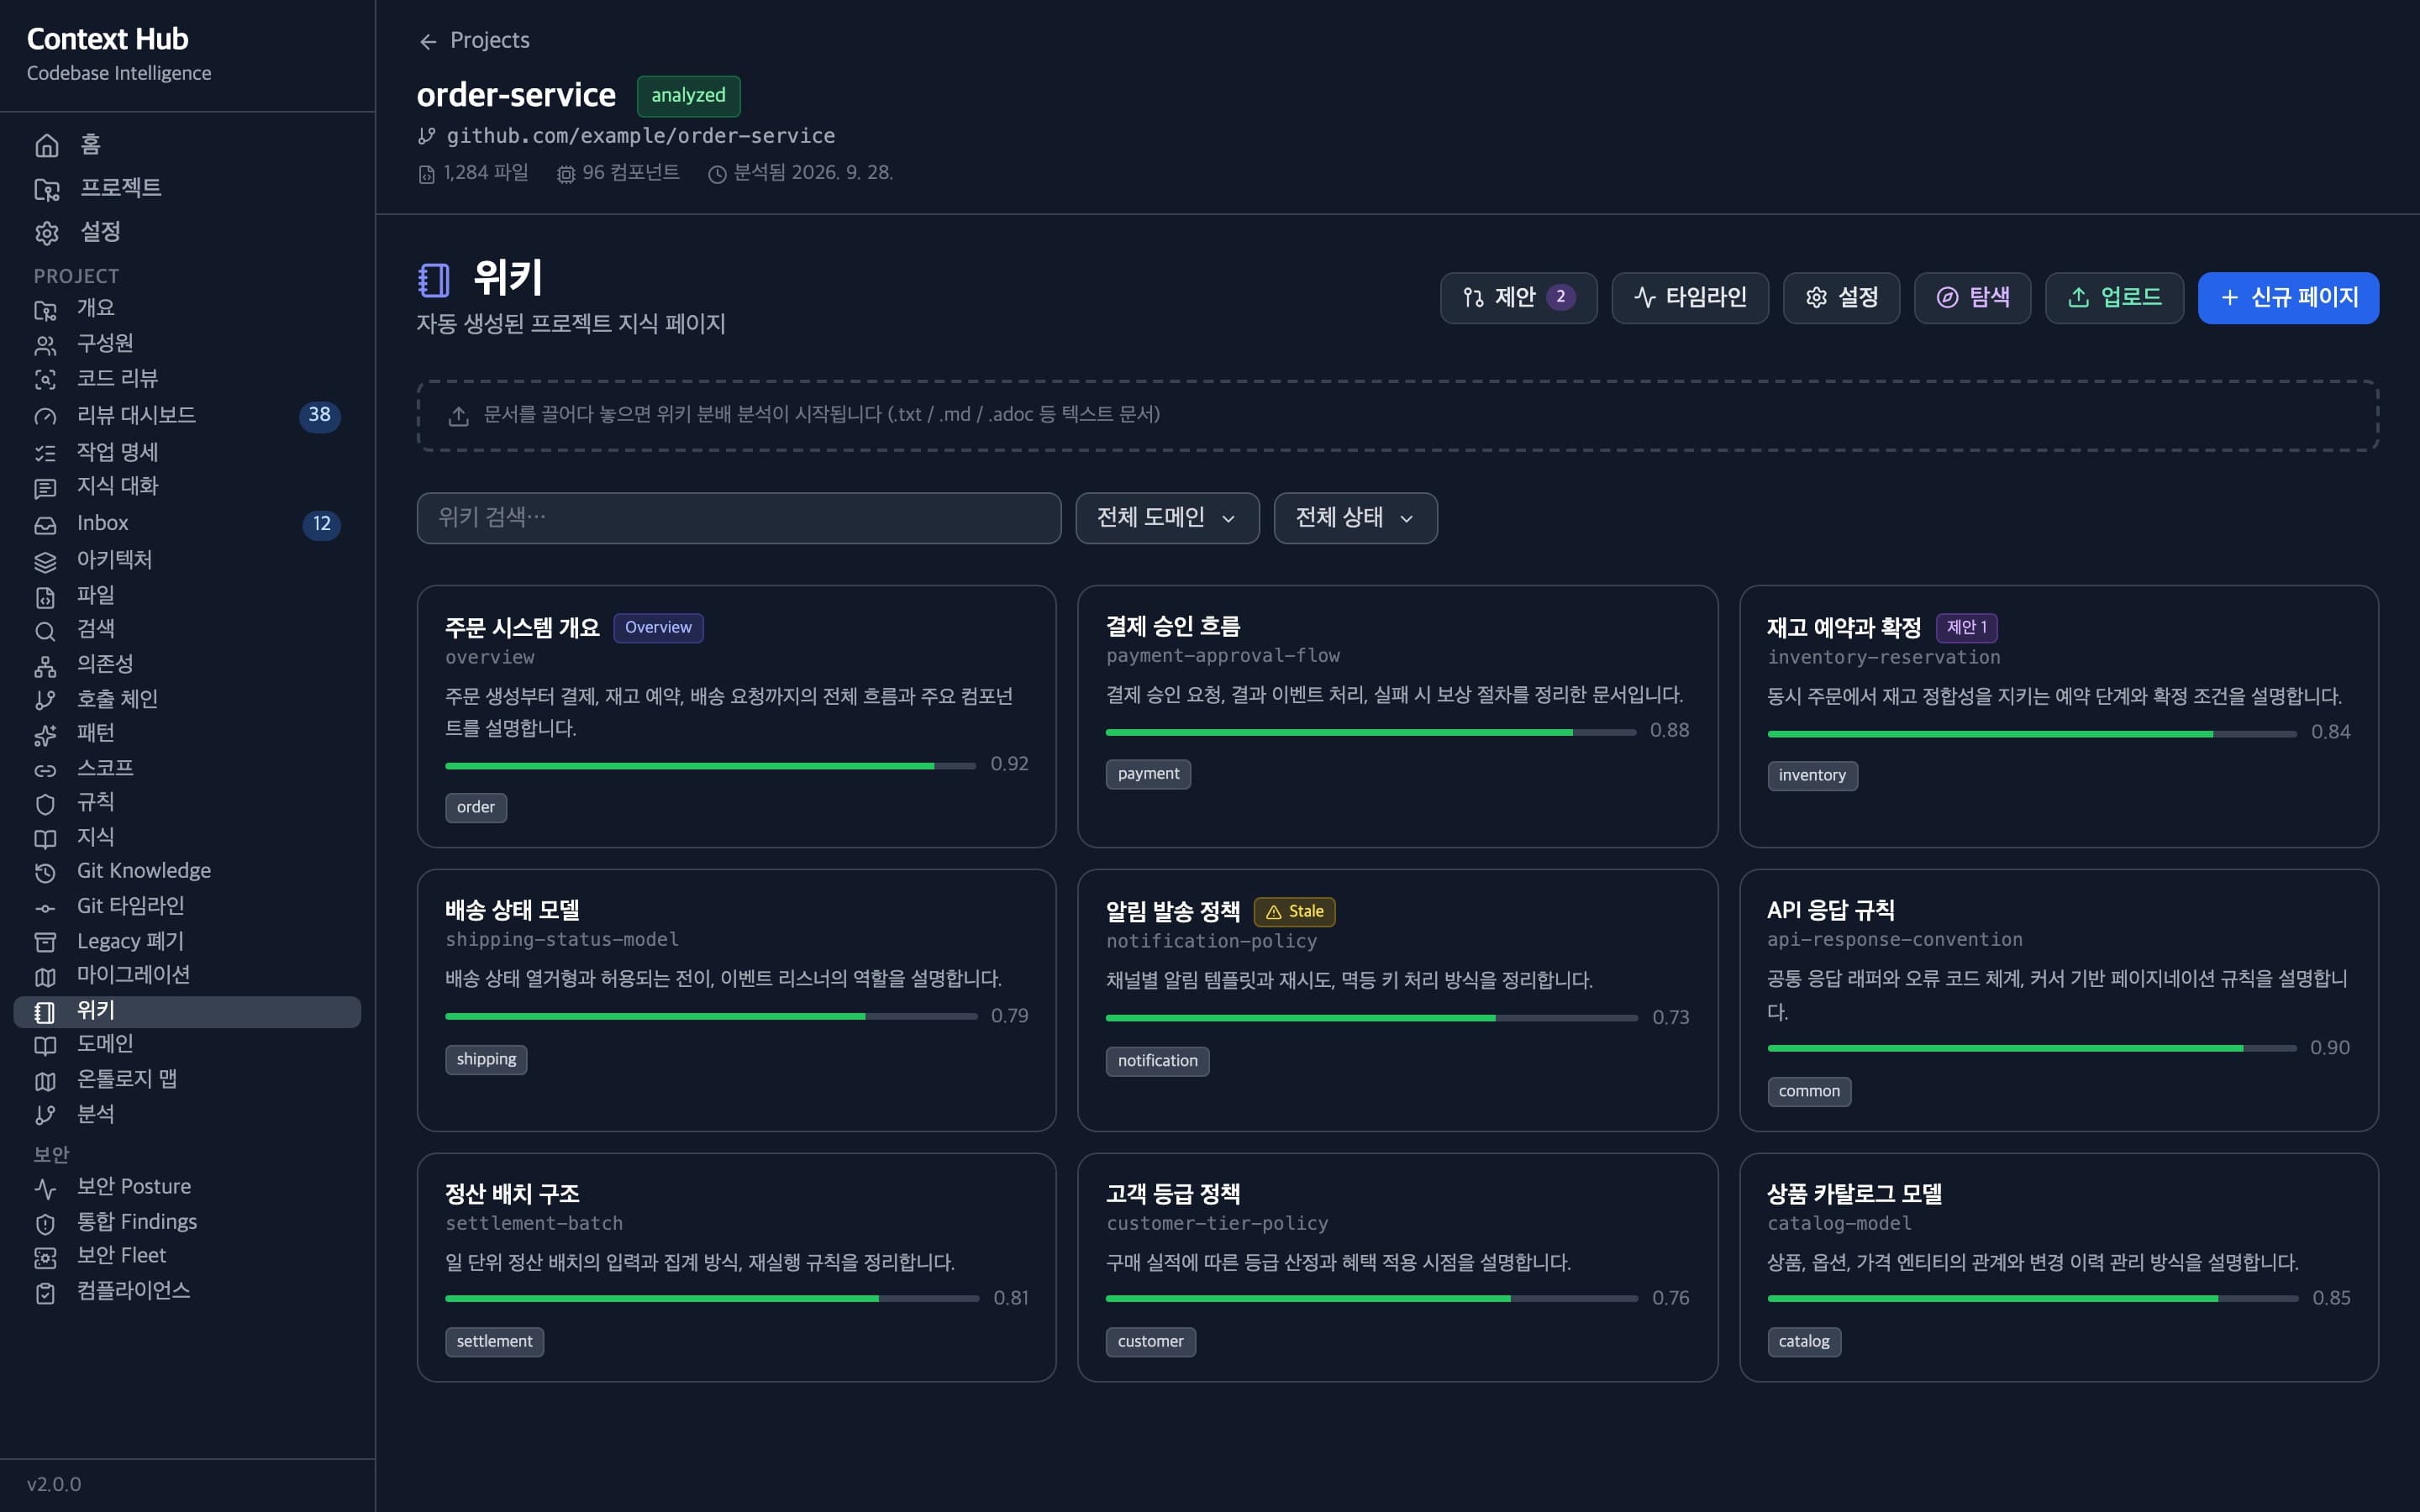
저장소 분석 결과를 바탕으로 엔티티, 컴포넌트, 시스템 개요 문서를 만들어 프로젝트 위키로 보관합니다. 각 문서는 제목, 요약, 신뢰도 점수를 담고 코드가 바뀌면 내용이 낡았다는 표시가 붙습니다. 문서를 직접 고치면 이전 버전이 변경 이력으로 남고, 텍스트 문서를 올리면 알맞은 위키 항목으로 나눠 넣습니다. 소스 코드와 설명 문서가 어긋나지 않도록 항상 최신 상태를 유지합니다.
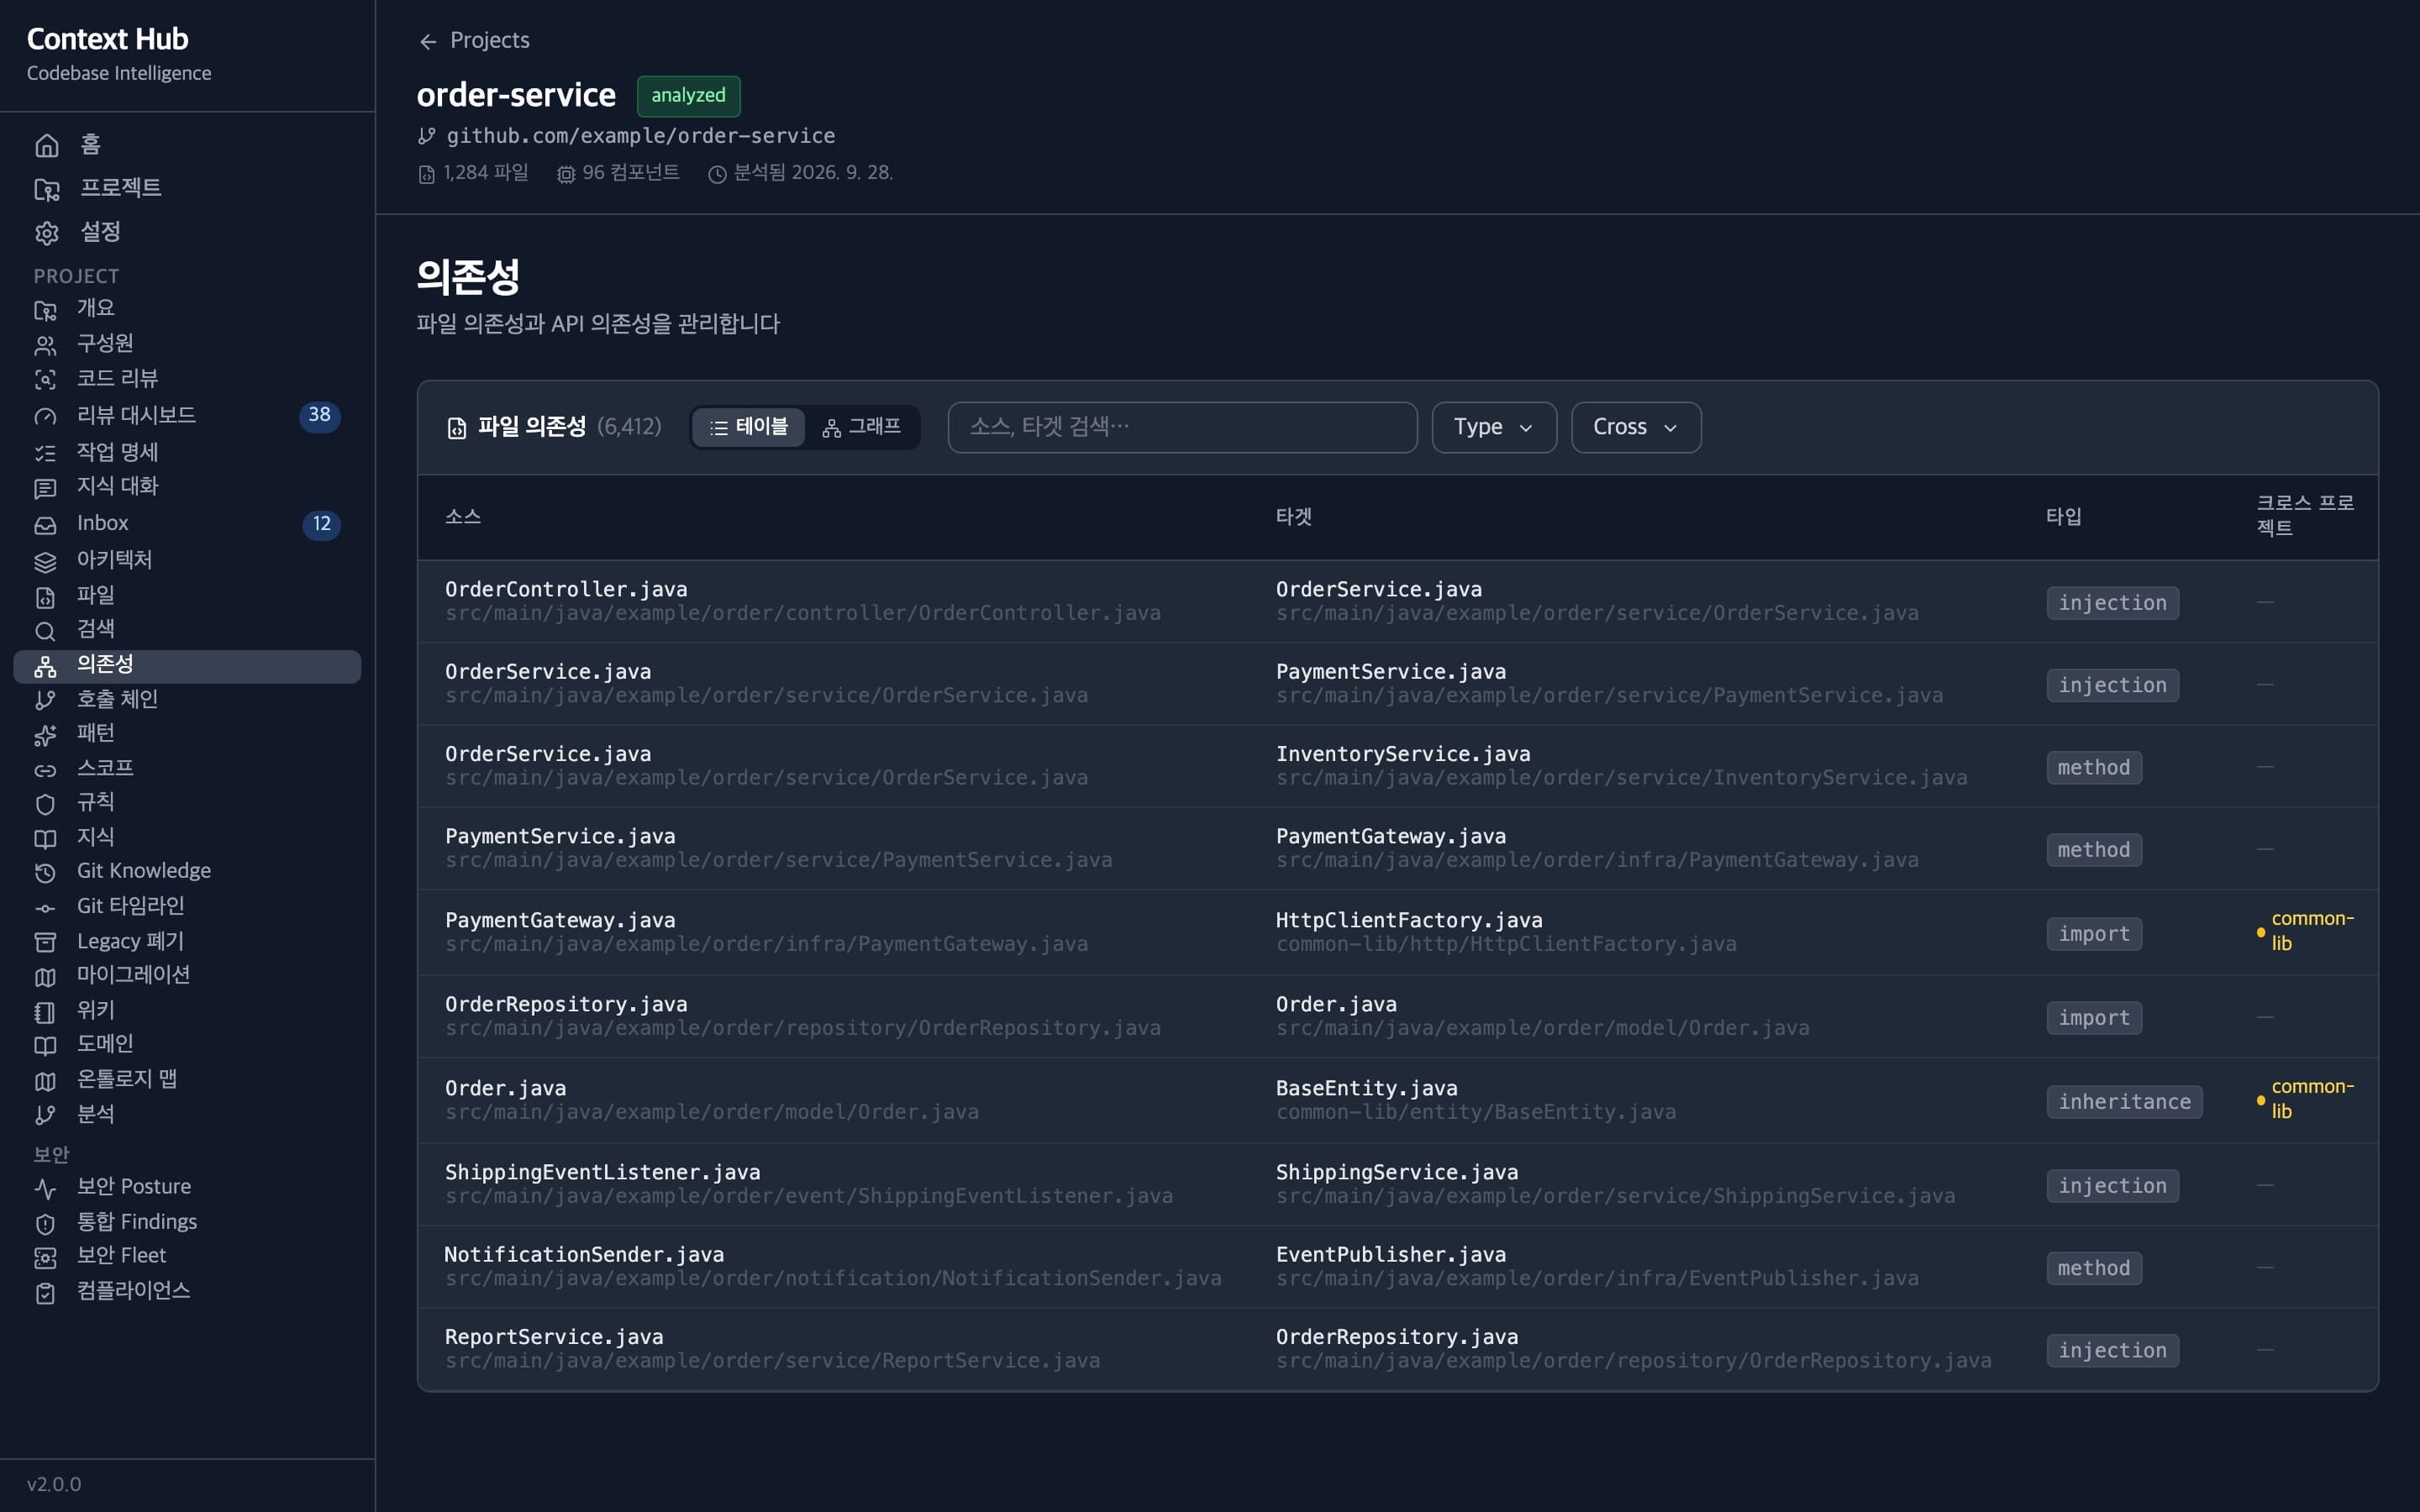
파일끼리 참조하는 관계와 외부 API 호출 관계를 분석해 연결 상태를 봅니다. 의존성 종류는 import, 메서드 호출, 주입, 상속으로 나뉘며 출발 파일과 대상 파일이 기록됩니다. 다른 프로젝트를 참조하는 외부 의존성은 프로젝트 이름과 함께 묶어 저장소 경계를 넘는 영향까지 짚어 냅니다. 자주 쓰는 공통 모듈을 고치기 전에 어떤 코드가 연결되어 있는지 미리 확인합니다.
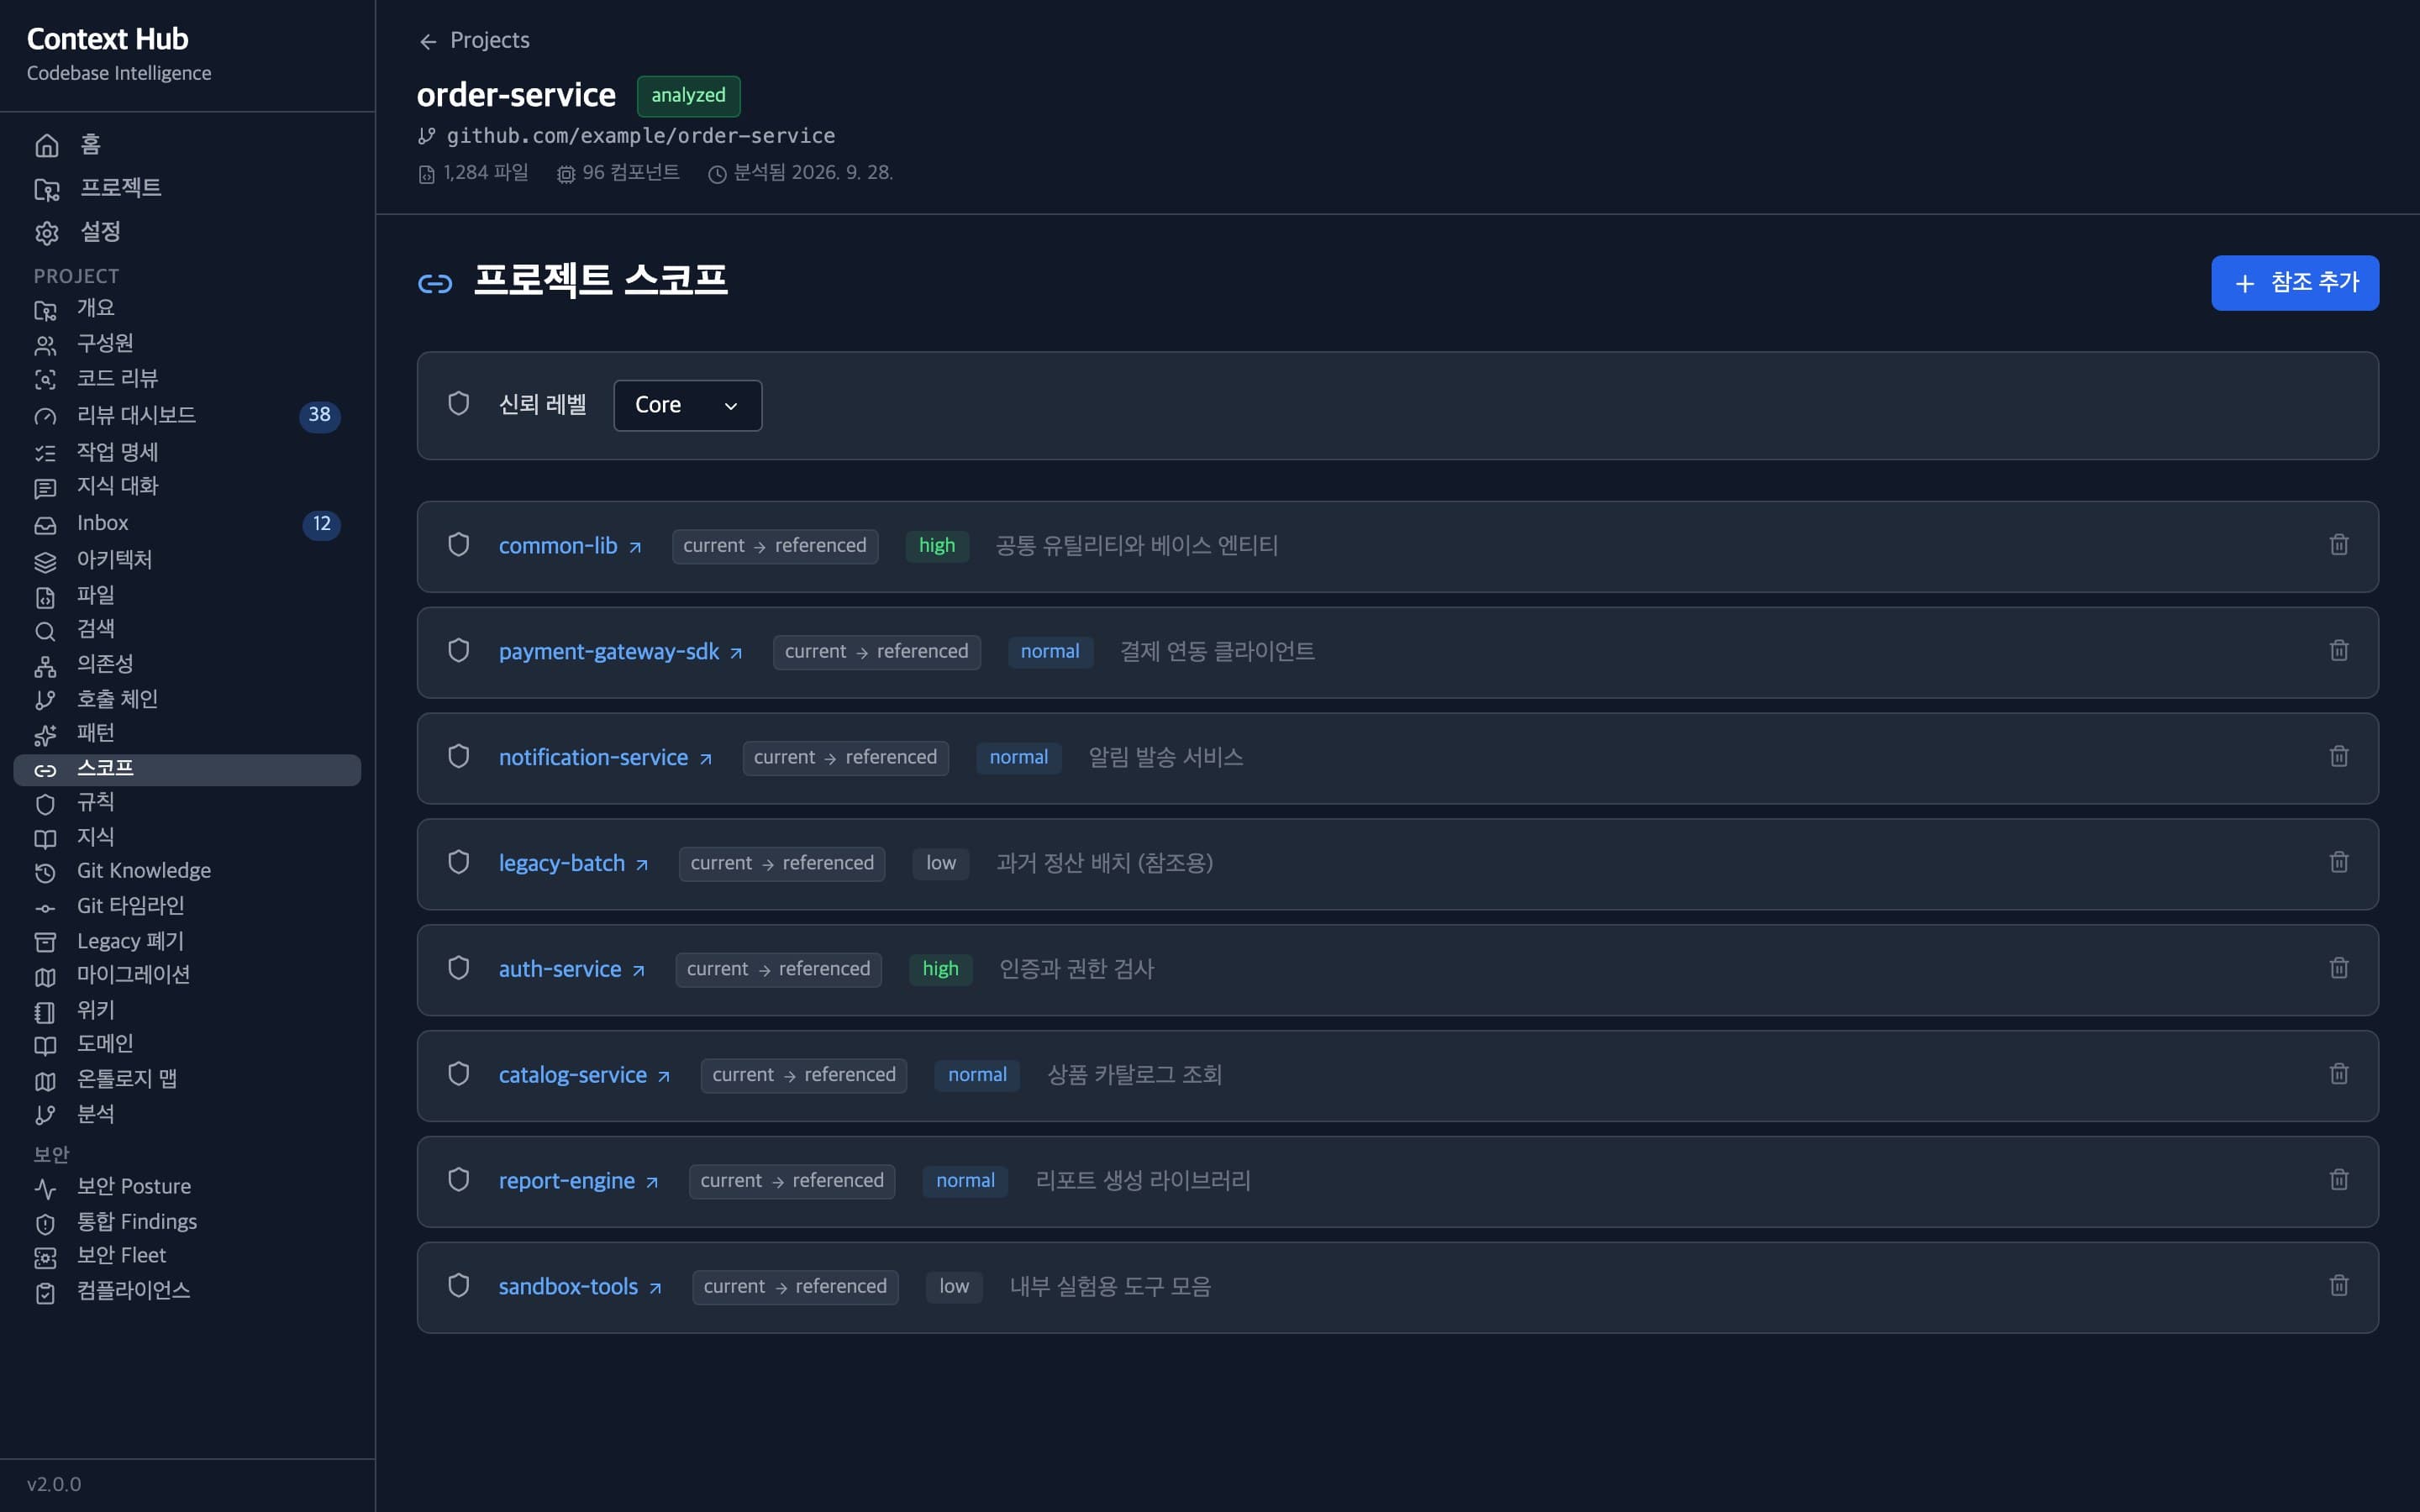
프로젝트가 참조할 다른 저장소 목록을 등록하고 대상마다 신뢰 수준과 역할을 지정합니다. 신뢰 수준은 핵심, 보통, 낮음, 실험, 폐기로 나뉘며 공통 코어 저장소와 단순 참고 저장소의 비중을 달리 둡니다. 저장소 참조에는 우선순위가 붙어 검색이나 지식 조회를 할 때 허용된 범위 안의 코드만 가져옵니다. 여러 서비스를 함께 개발할 때 서로 다른 규칙과 컨벤션이 뒤섞이지 않게 분리합니다.
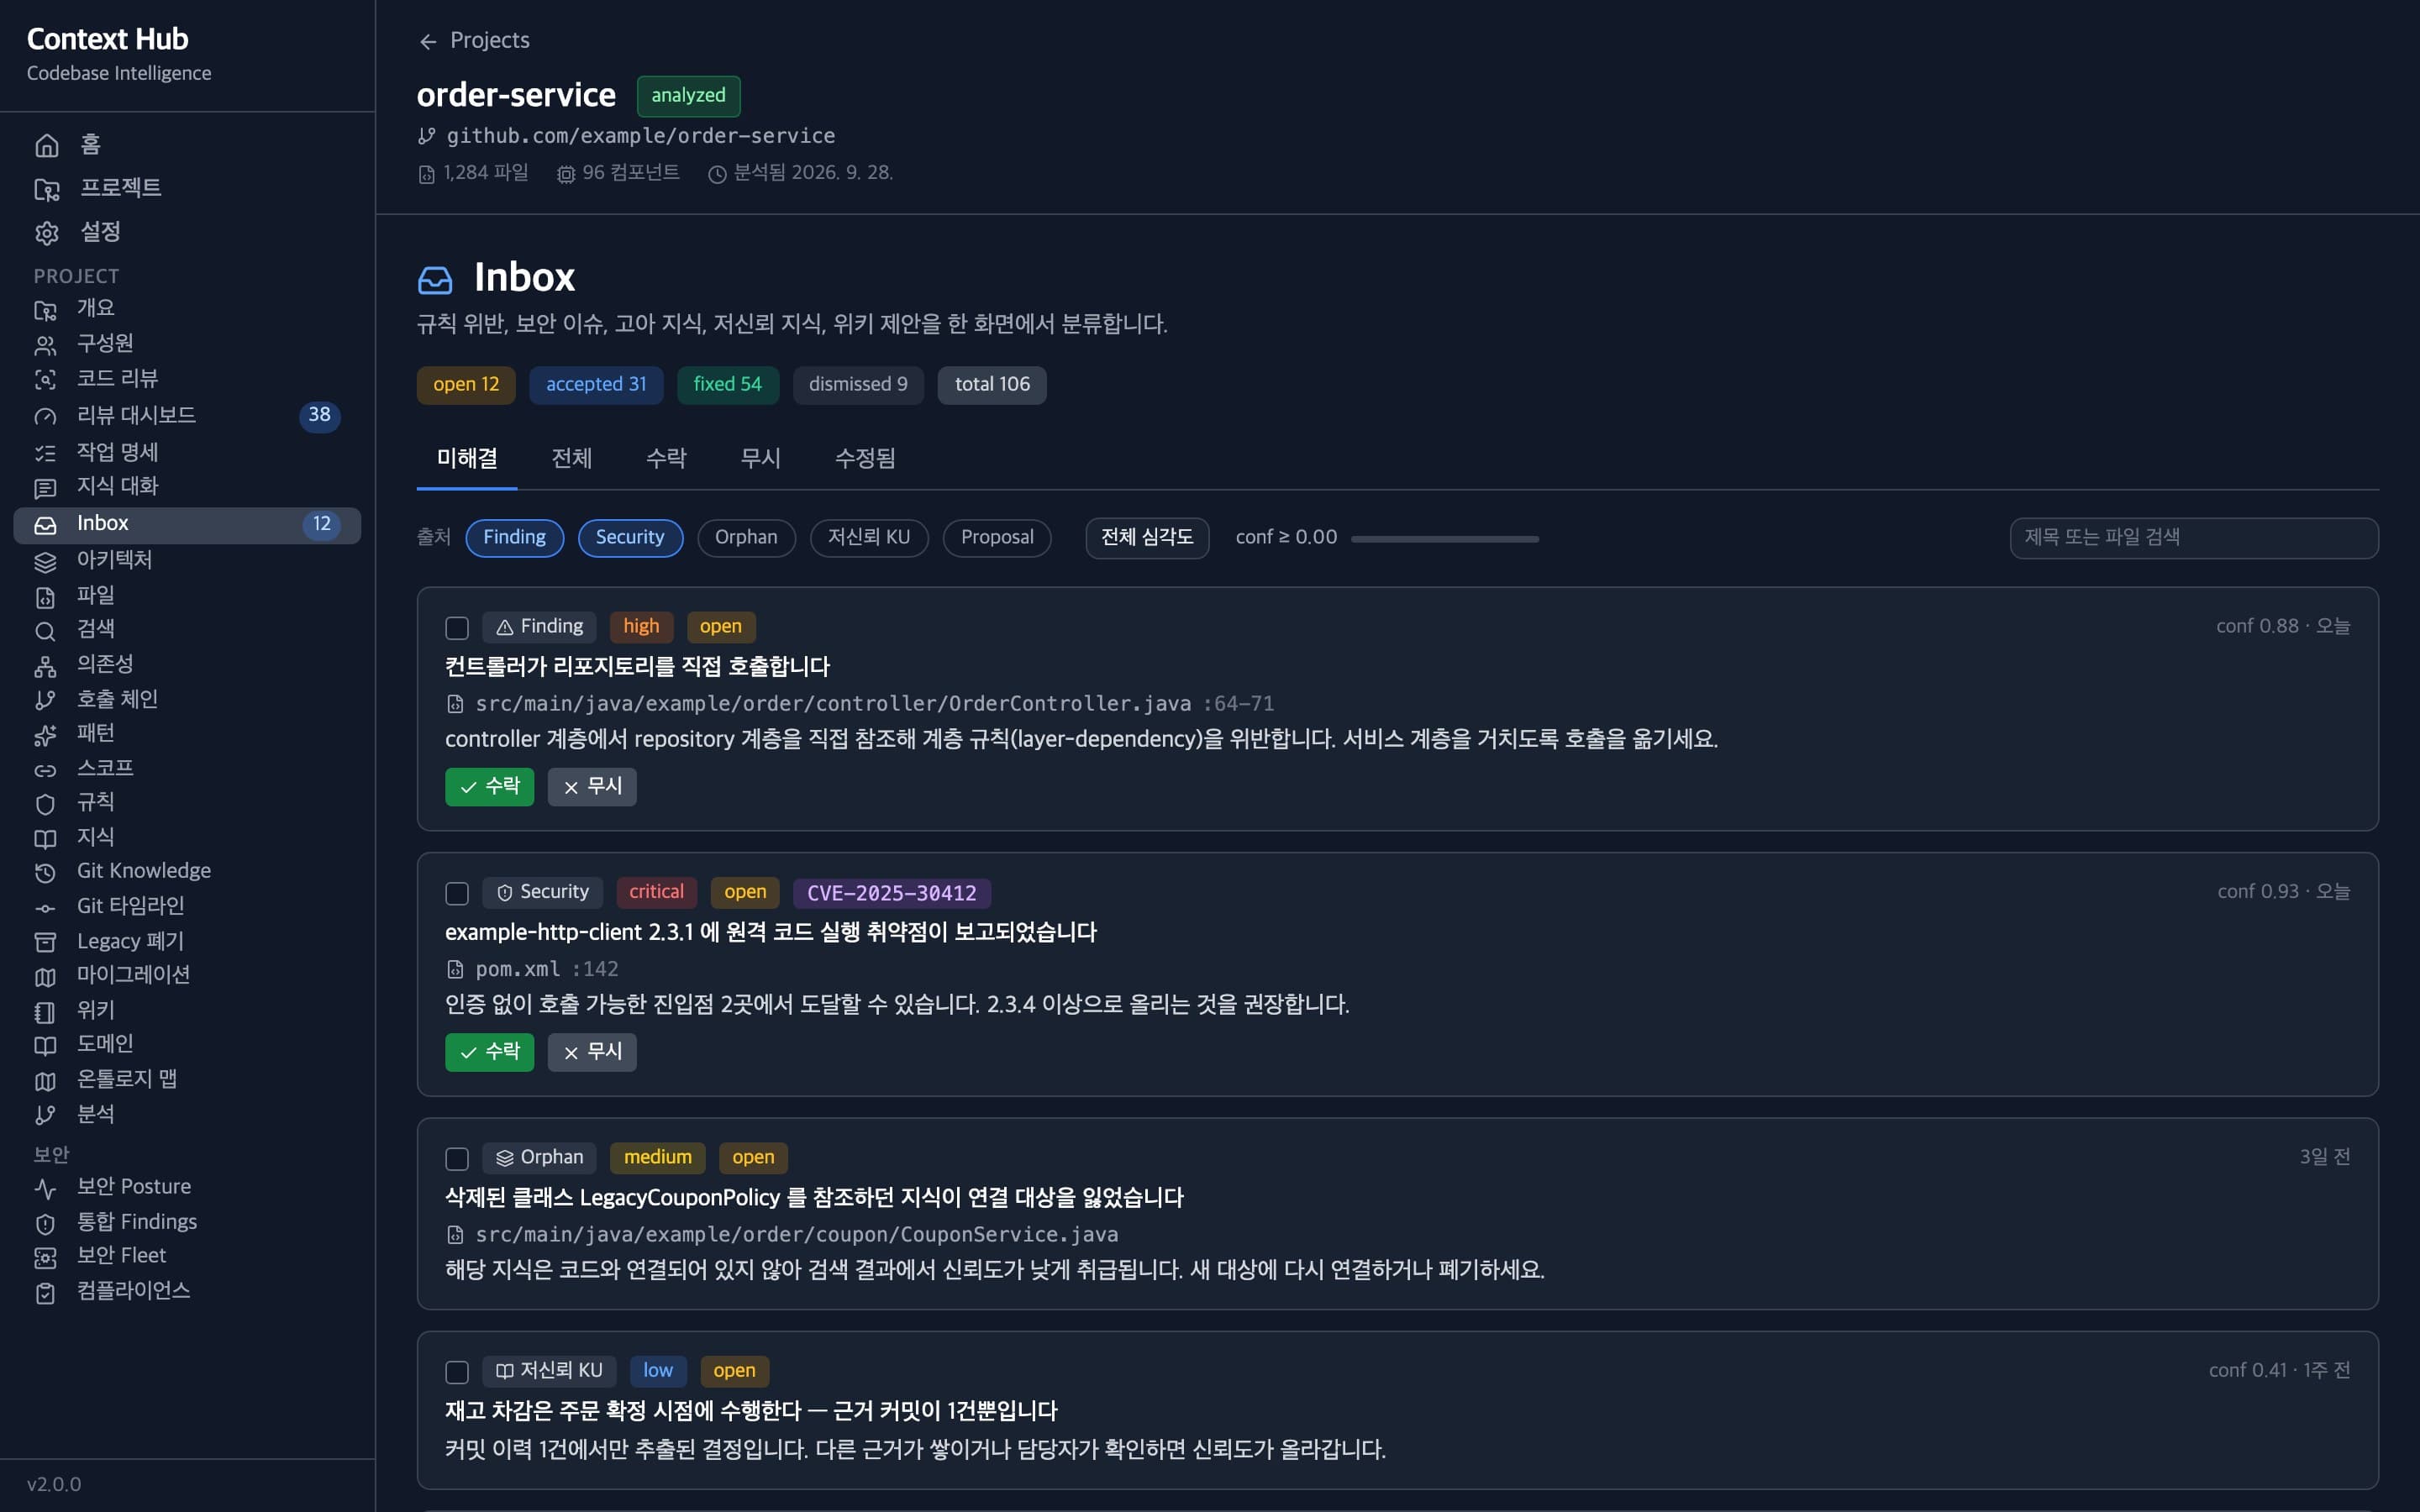
코드 규칙 위반, 보안 문제, 고아 지식, 저신뢰 지식, 위키 변경 제안을 수신함 하나로 모읍니다. 각 항목은 미해결, 수락, 해결 완료, 기각 상태를 거치며 심각도와 신뢰도에 따라 처리 순서를 정합니다. 연결된 코드가 사라진 지식이나 근거가 약한 지식은 담당자가 직접 확인해 지우거나 고칩니다. 여러 곳에 흩어져 있는 점검 거리를 한 화면에서 검토하고 여러 건을 한 번에 처리합니다.
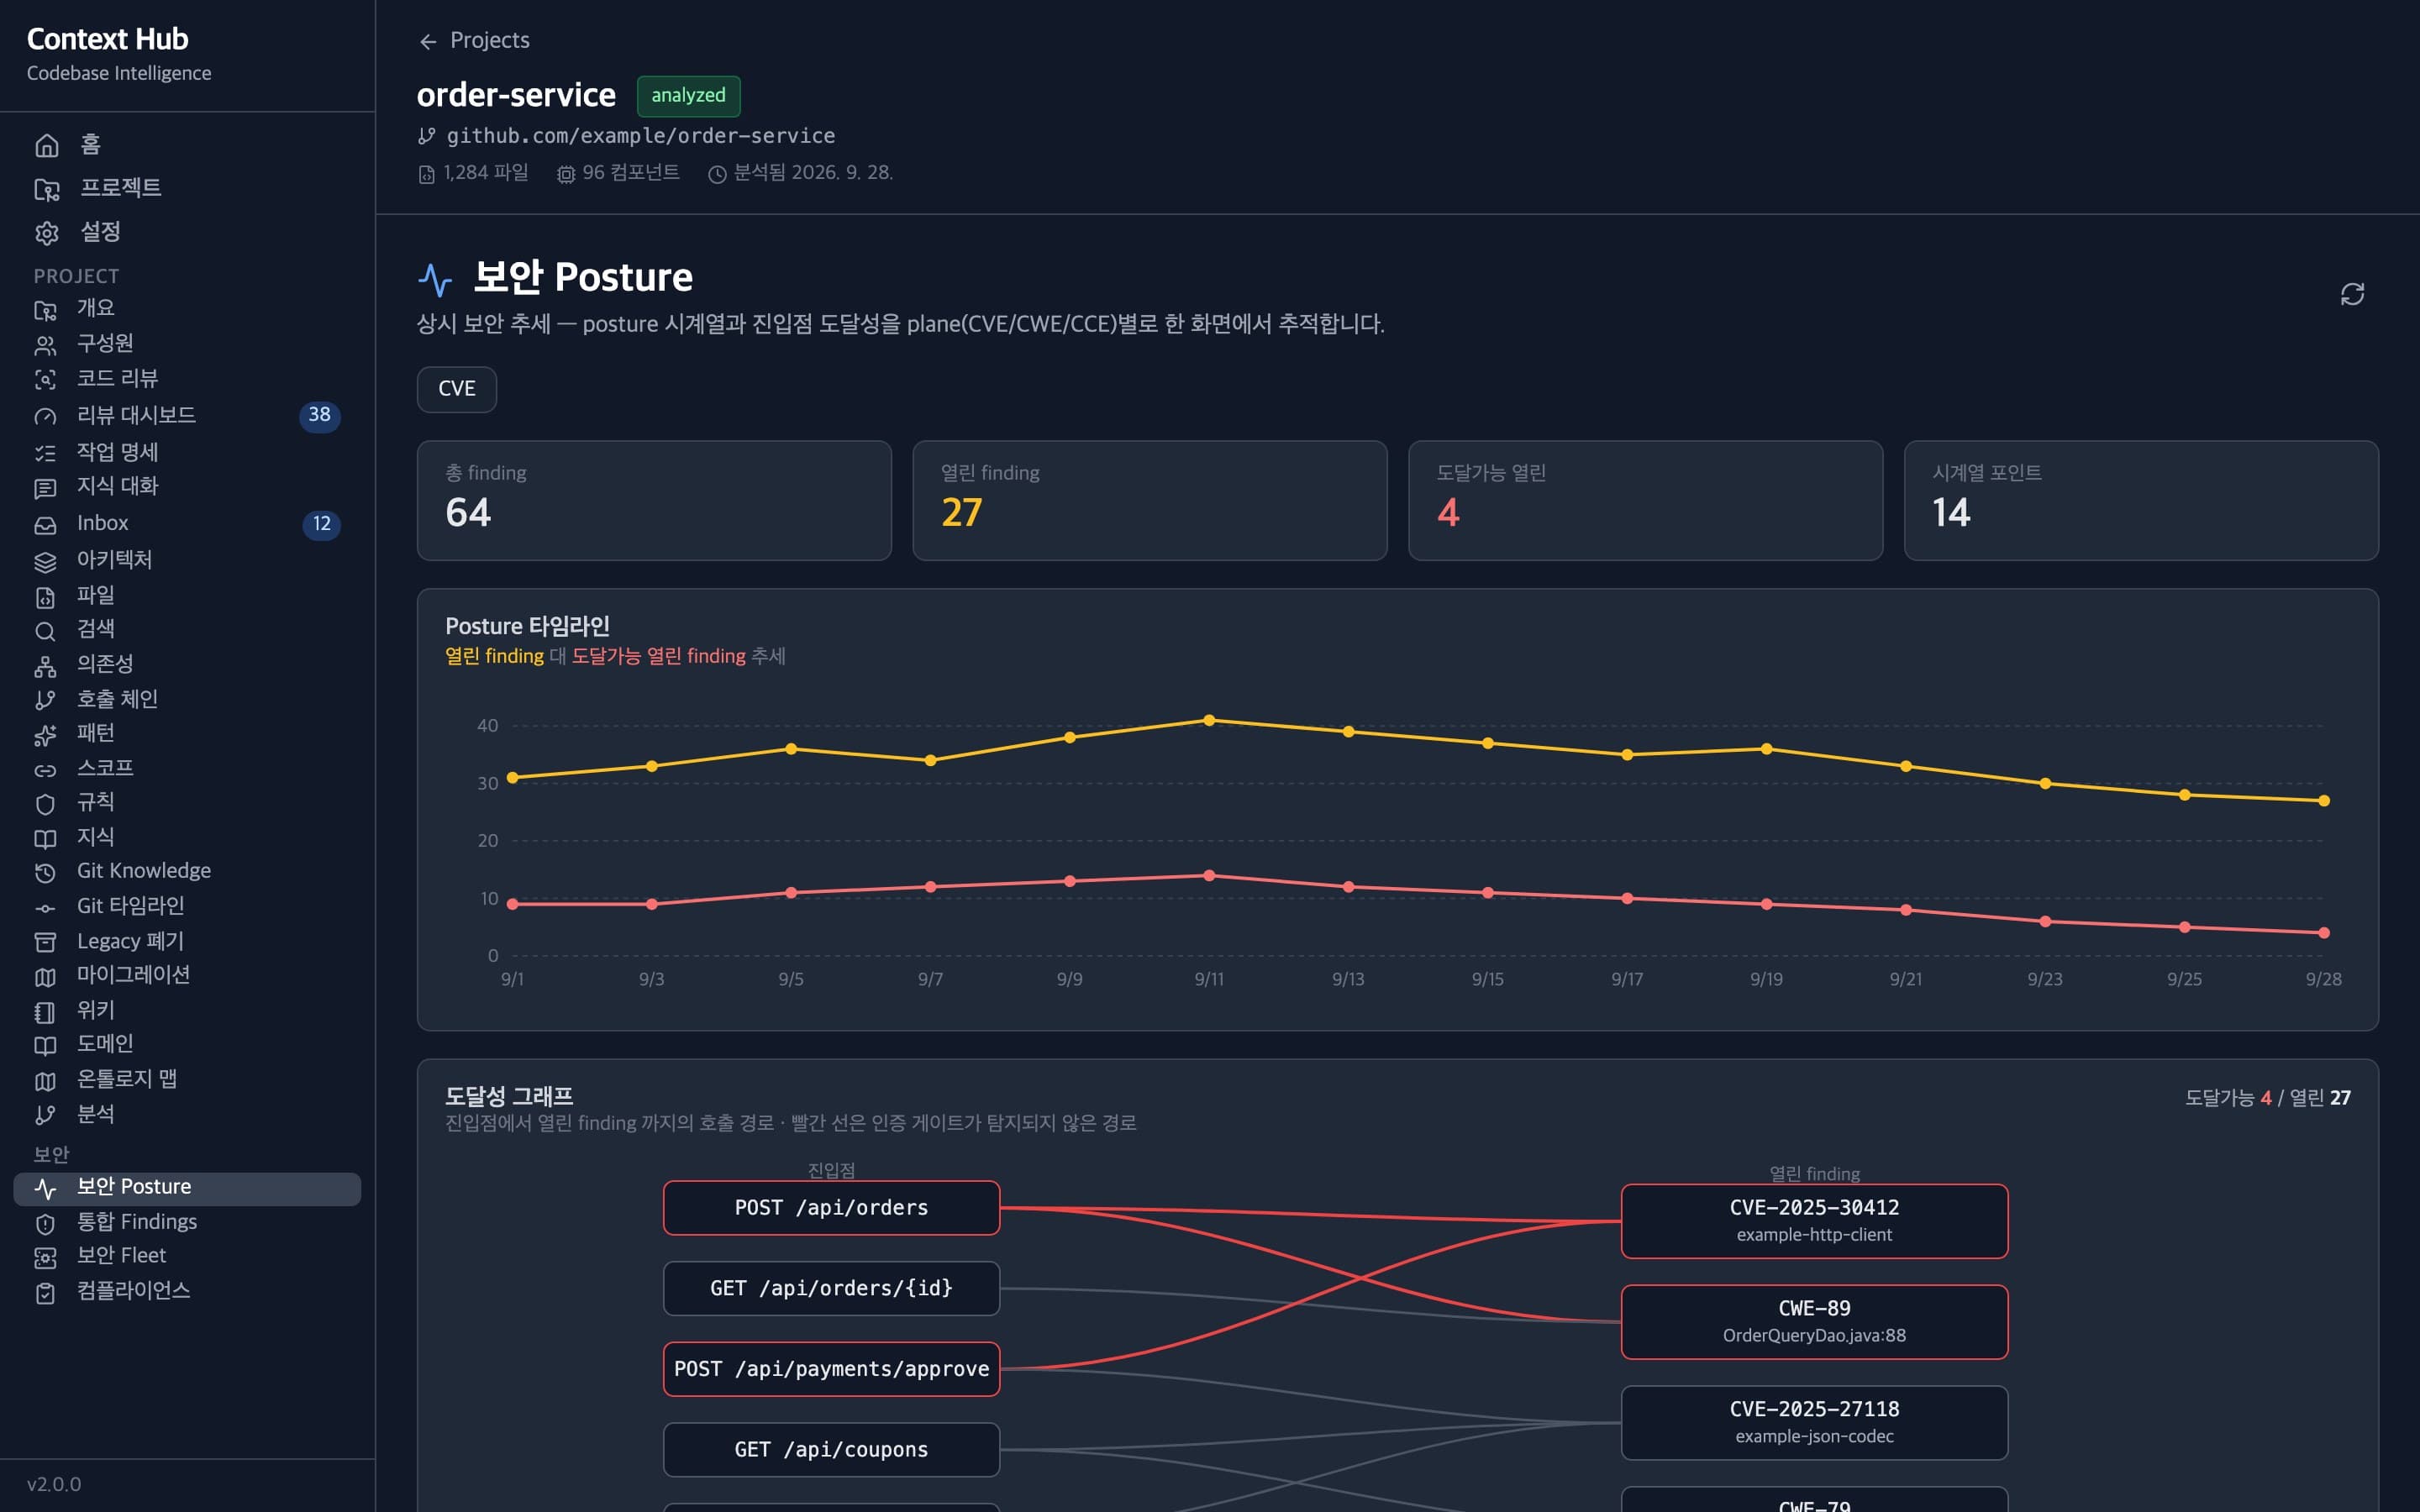
패키지 취약점 CVE, 코드 약점 CWE, 설정 오류 CCE 세 방면의 보안 노출도를 시간 순서대로 추적합니다. 진입점부터 취약한 코드까지 호출 경로를 따라가 실제로 닿을 수 있는지와 인증 문턱이 있는지 확인합니다. 아무 인증 없이 외부에서 바로 닿는 미해결 취약점 수를 가장 위험한 지표로 삼아 변화를 봅니다. 이론적인 위험과 실제 공격받을 수 있는 경로를 갈라내 먼저 손봐야 할 대상을 고릅니다.
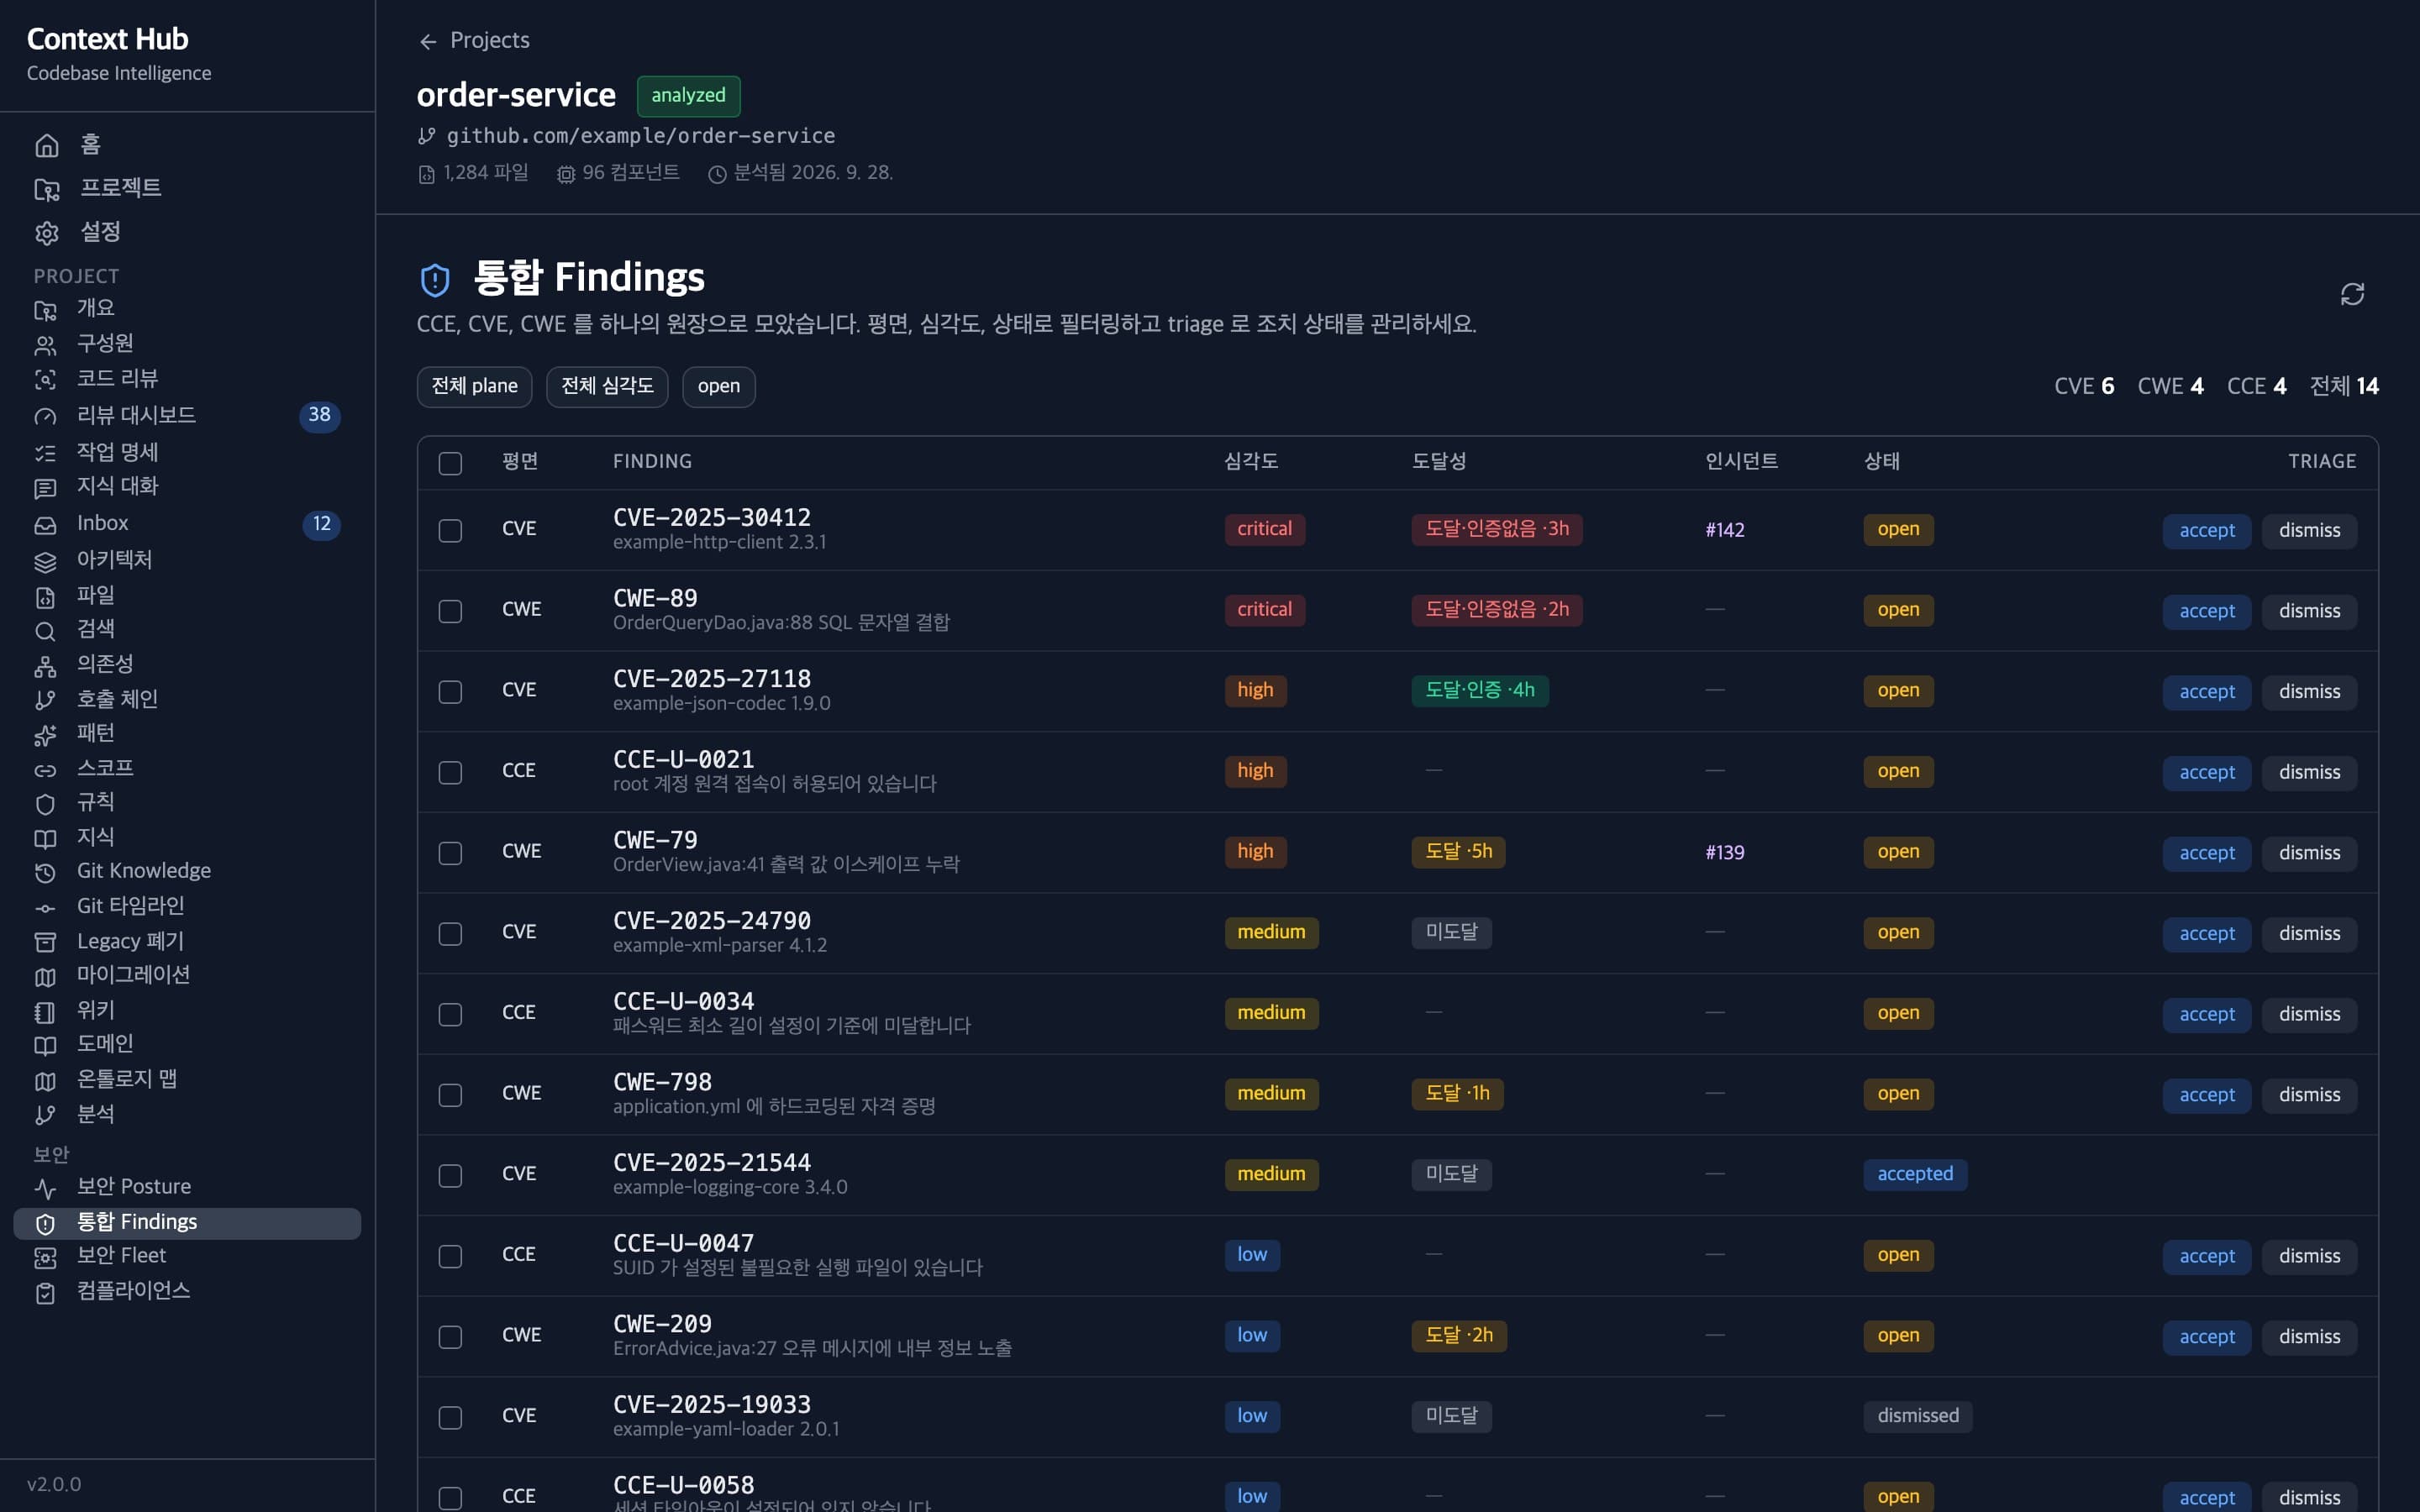
패키지 결함, 정적 분석 약점, 호스트 설정 오류를 보안 원장 하나에 모아 관리합니다. 취약점마다 위험 종류, 심각도, 진입점 도달 여부, 관련 인시던트, 조치 상태를 적어 둡니다. 담당자는 취약점을 수용, 조치 완료, 기각으로 나누어 처리하며 기각한 이유도 감사 기록으로 남깁니다. 서로 다른 검사 도구의 결과를 같은 기준으로 정리해 빠뜨리는 항목 없이 처리합니다.
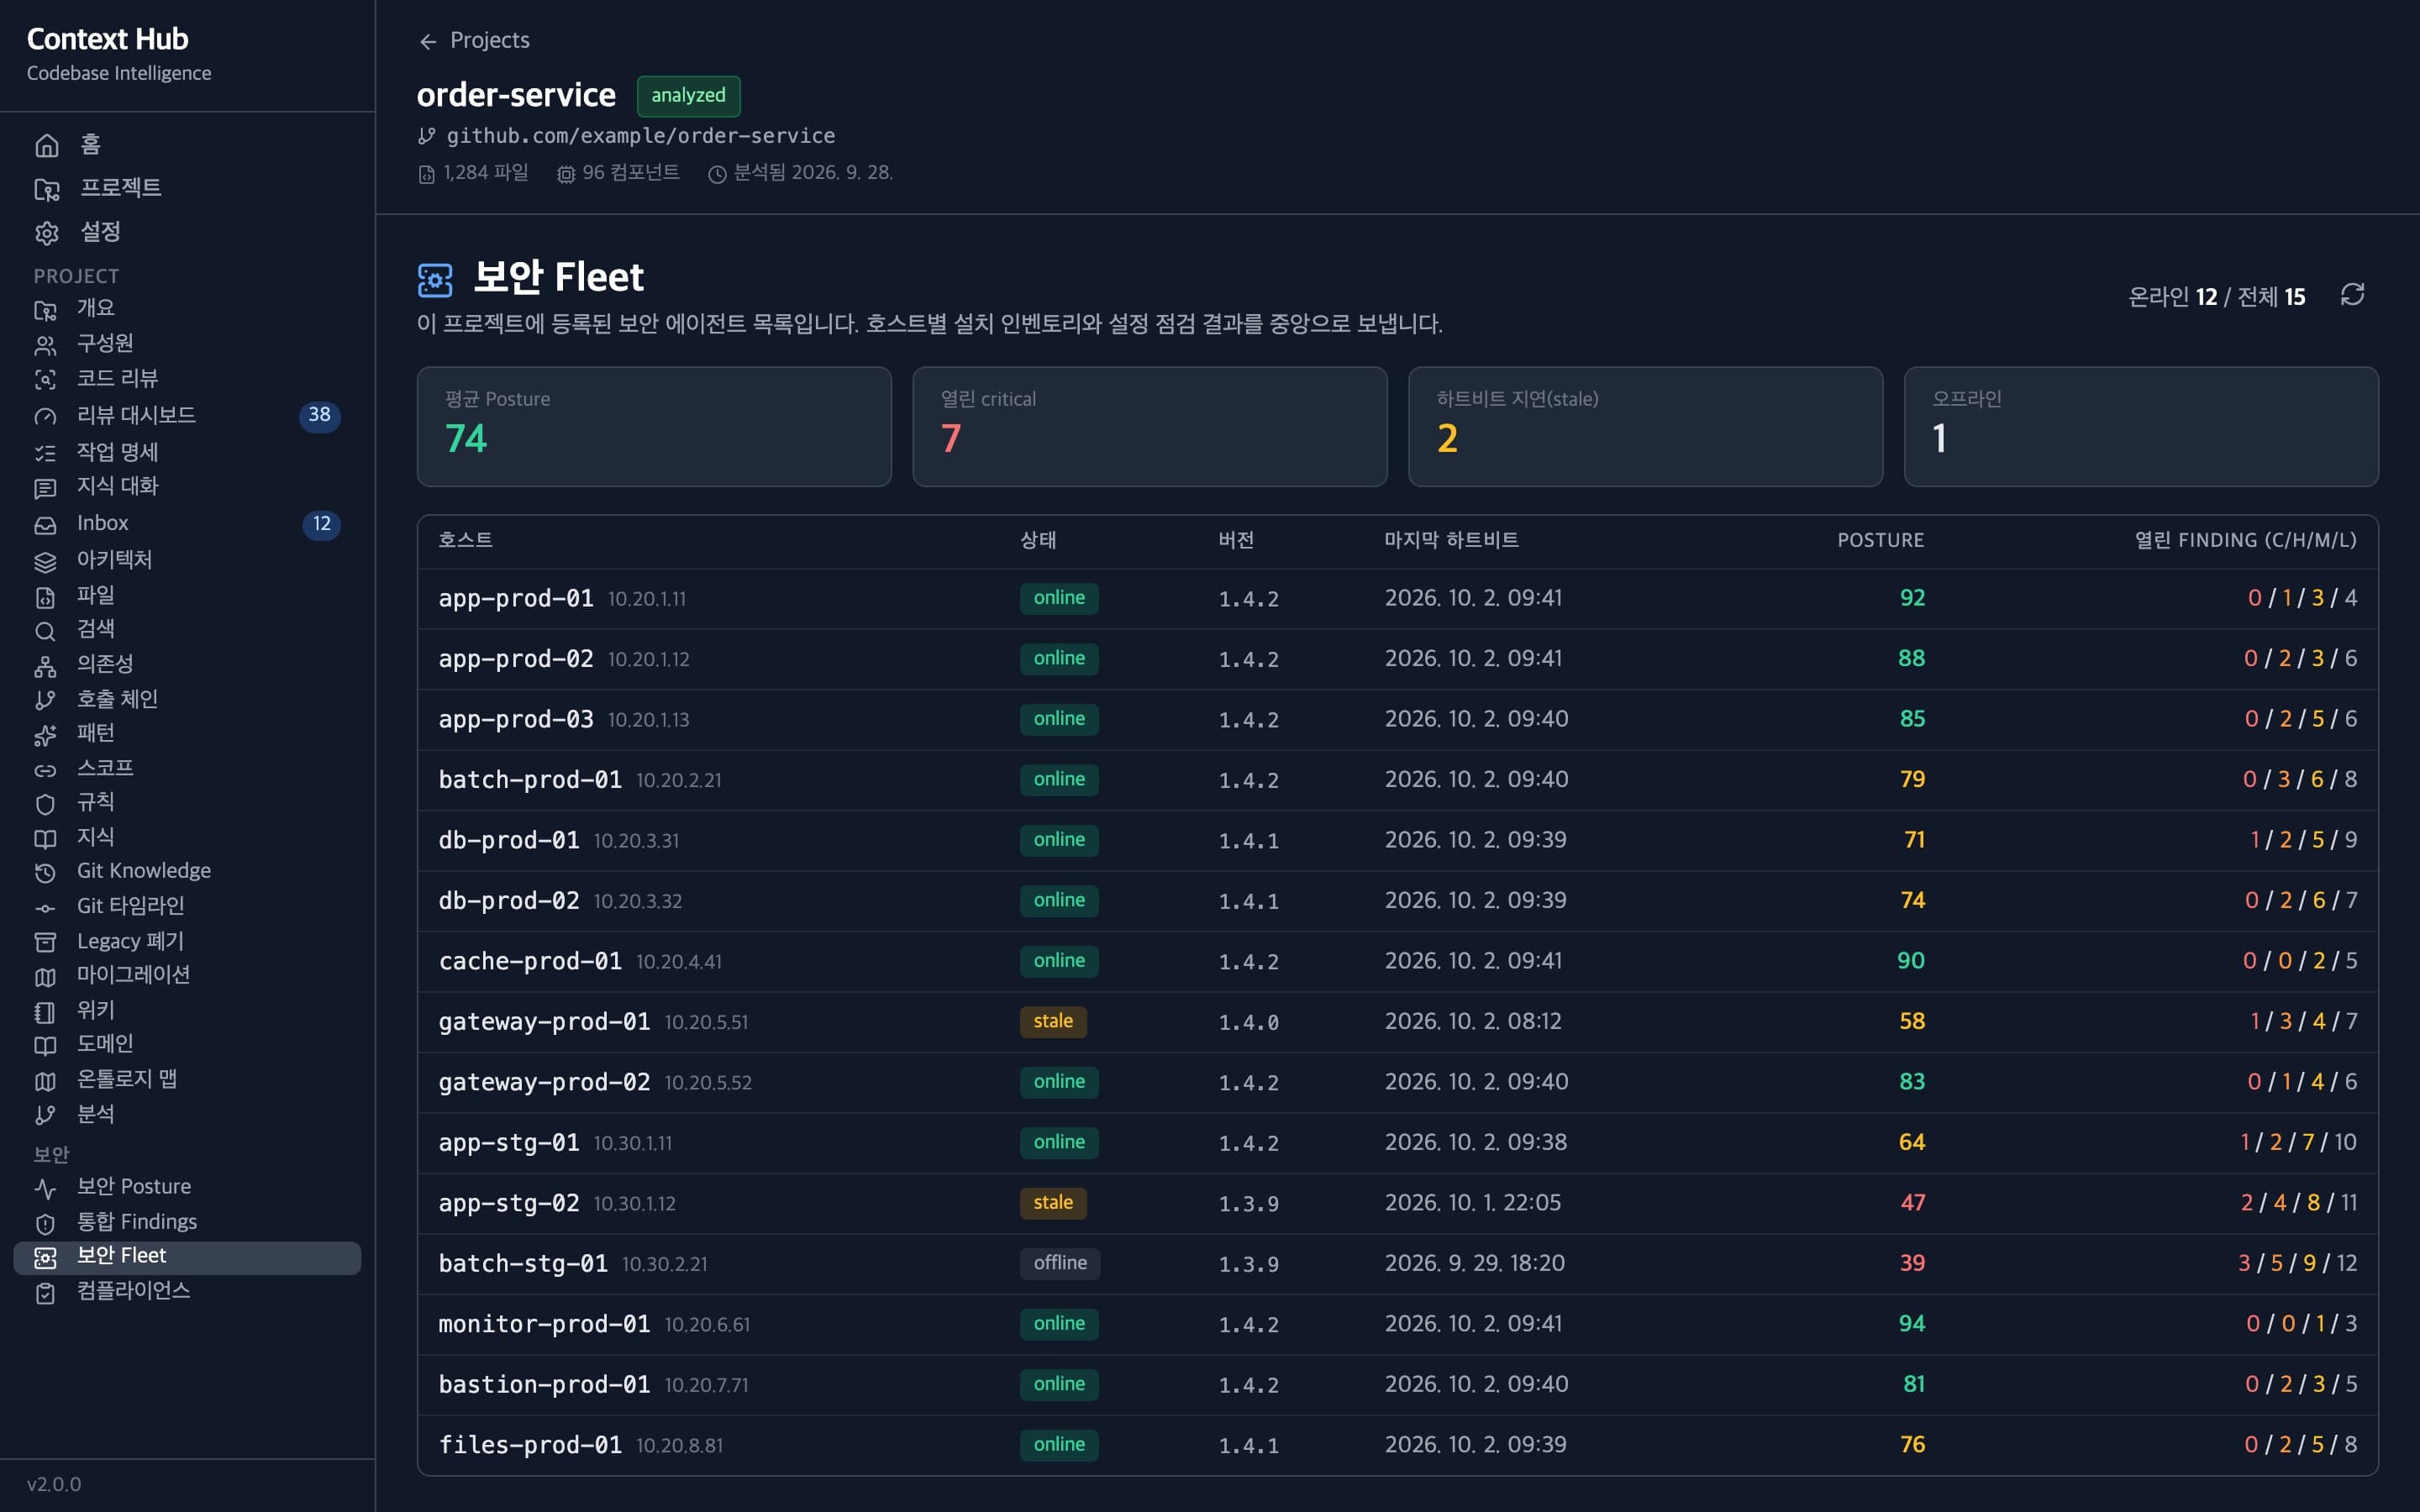
운영 서버에 설치한 경량 보안 에이전트의 상태와 점검 결과를 호스트별로 살펴봅니다. 에이전트는 설치 패키지와 보안 설정을 읽기만 해서 중앙 서버로 보내므로 외부 접속 포트를 열지 않아도 됩니다. 호스트마다 하트비트 신호를 확인해 정상, 지연, 연결 끊김으로 상태를 나누고 점수를 매깁니다. 서버 설정이 바뀌었는지 확인하고 점검 데이터 수집이 멈춘 서버를 찾아냅니다.
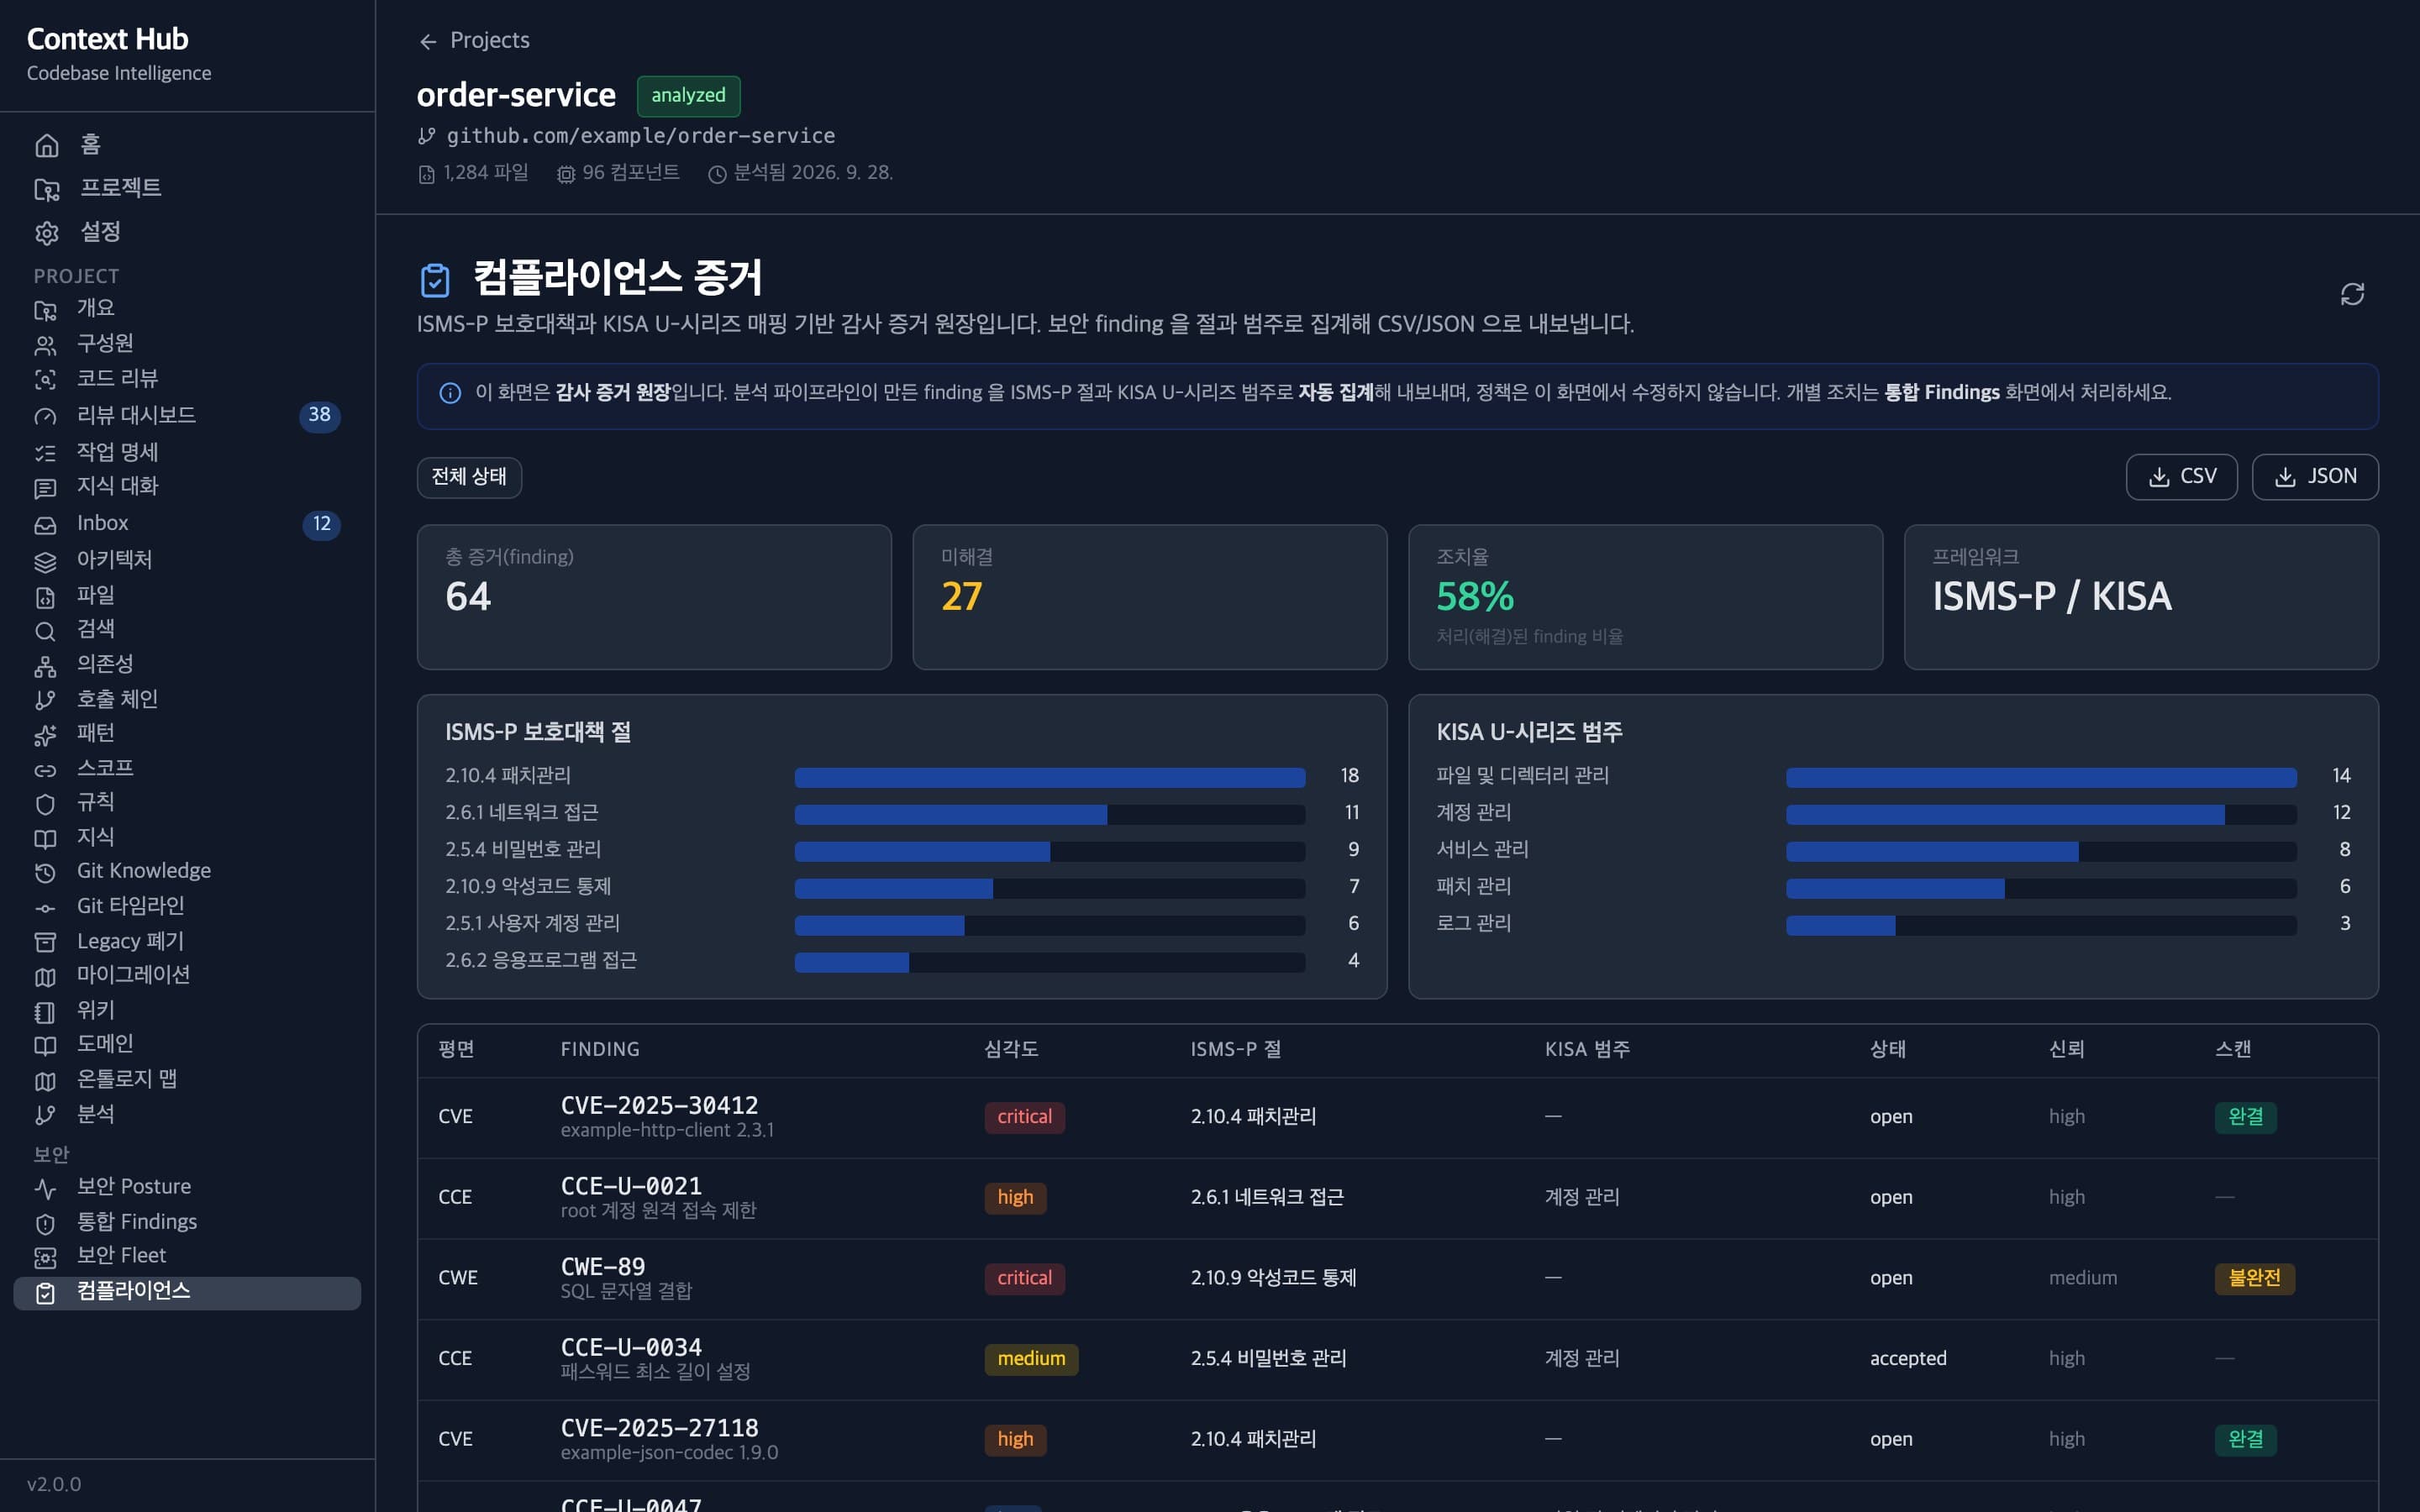
발견된 보안 취약점을 ISMS-P 보호대책 조항과 KISA 점검 기준 범주에 자동으로 연결합니다. 인증 기준 조항별로 전체 증적 건수와 아직 안 풀린 건수를 모으고 조치 완료 비율을 계산합니다. 증적 원장에는 취약점 종류, 심각도, 해당 조항, 처리 상태를 적고 CSV나 JSON 파일로 내려받을 수 있습니다. 보안 감사나 규제 점검을 받을 때 필요한 기술 증빙 자료를 수작업 없이 추출합니다.
파일이나 메서드를 바꿀 때 영향받는 호출자와 함께 바뀐 이력 파일, 위험 점수를 계산합니다.
세션이 열릴 때 프로젝트 맥락을 채우고 편집 전후로 규칙 검사와 영향 분석을 실행합니다.
파일 요약과 관련 지식, 위키 문서, 주요 호출자, 도메인을 한 번에 조회합니다.
지식 사이의 지지, 의존, 대체 관계를 인터랙티브 그래프로 보여 줍니다.
저장소를 등록하면 파싱부터 의존성, 지식, 패턴, Git 이력 분석까지 순서대로 이어집니다.
파일 해시를 비교해 두 번째 분석부터 바뀐 파일만 골라 다시 처리합니다.
Java, TypeScript, TSX는 구문 트리로 분석하고 다른 언어는 LLM 폴백으로 해석합니다.
OpenAI 호환 엔드포인트의 상용 모델과 로컬 모델을 연결하고 실패 시 다음 모델로 넘기는 체인을 짭니다.
단일 서버에 도커로 올리며 코드와 지식이 바깥으로 나가지 않습니다.
기술 스택
Go · Fiber · PostgreSQL · pgvector · Redis · Tree-sitter · Next.js · Tailwind CSS